

表征
共 44 篇相关内容
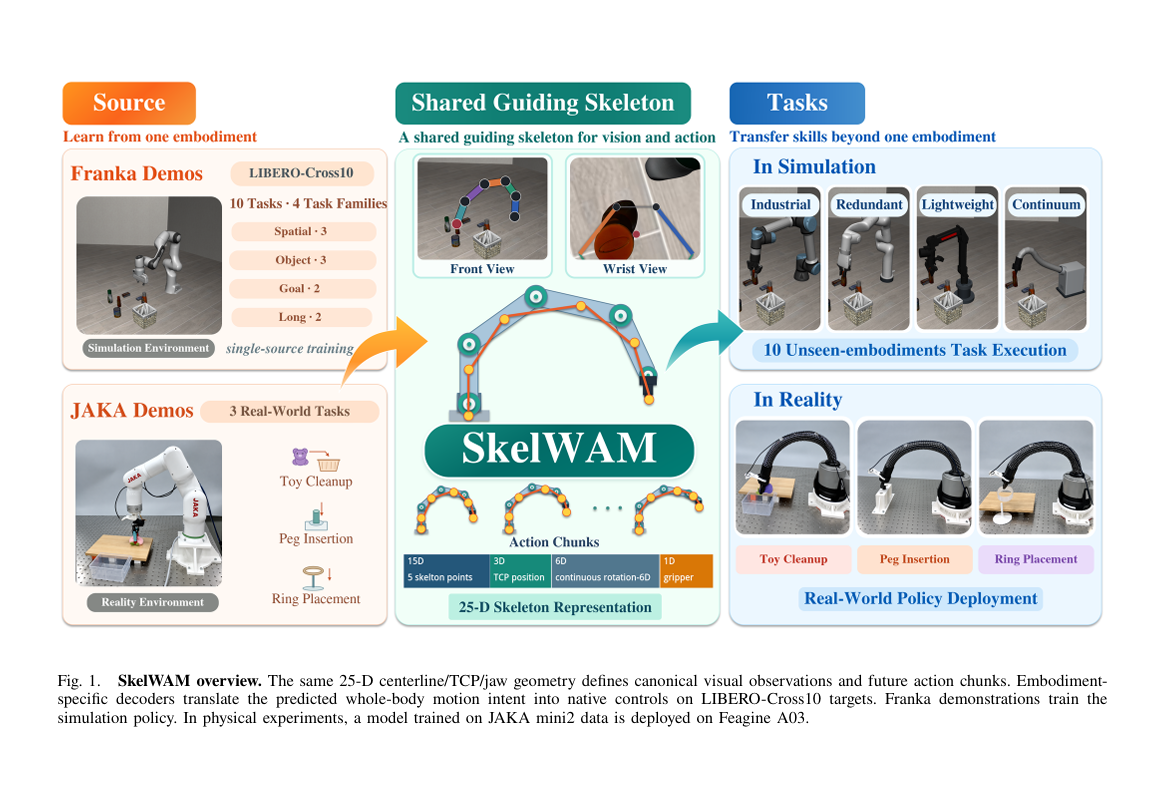
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移…
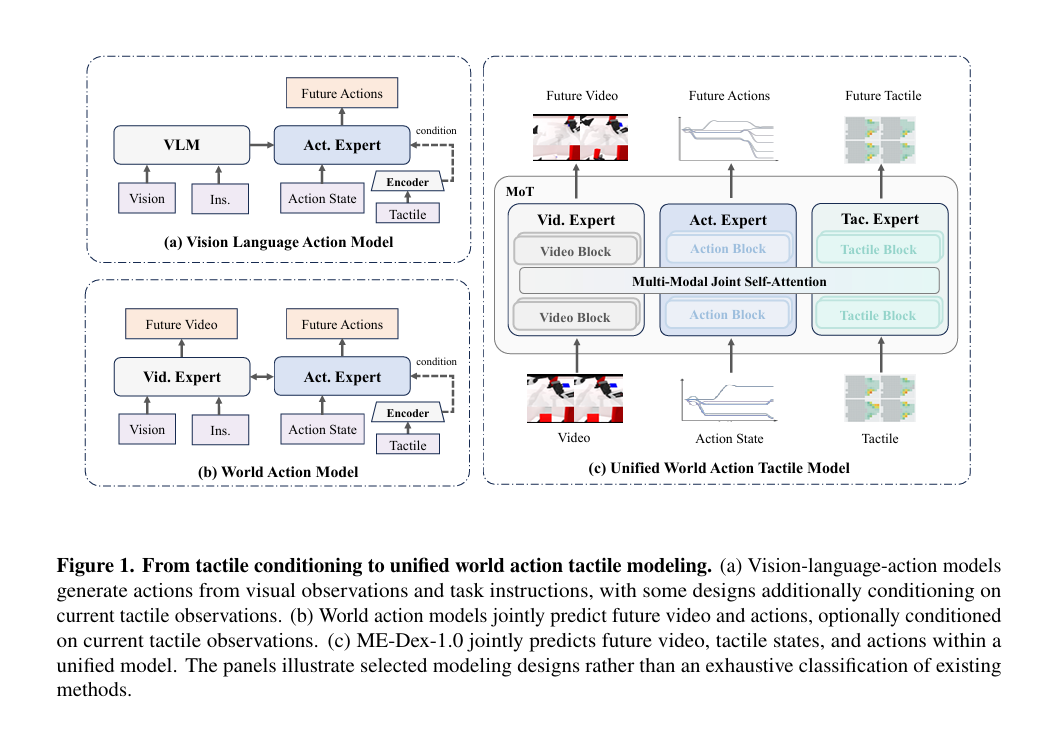
理想汽车基座模型团队提出 ME-Dex 1.0,让触觉和画面一起预测未来
ME Dex 1.0 让机器人在输出动作前,预先计算下一步会产生的接触状态。理想汽车基座模型团队将视觉、触觉、动作三路专家模块整合进同一个去噪框架;触觉与图像一样,被视作需要预测的未来观测。团队还借助手部模板,把不同灵巧手、夹爪的触觉信息对…
对话上海交大杨理欣:为什么机器人需要一条「三维时间轴」
机器人会倒水,却可能在放下瓶子后忘了刚才倒过哪一瓶。会执行动作,不等于知道任务该如何推进;机器人还需要把任务意图、行动历史与世界变化连成一条三维时间线。 这类失败不完全是抓取精度问题。今天的视觉—语言—动作模型(Vision Languag…
星海图赵行:机器人的下一次 Scaling,不只发生在预训练
机器人抓起一个商品,只能说明它会做一个动作。展台上的机器人完成一次抓取,与它进入前置仓持续接单、拣选和打包,是两种不同的考验。 前者可以被压缩成一条成功轨迹,后者却要求机器人理解订单、定位货架、自主导航、处理随机摆放的商品,还要在多机协同时…
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
首次!北大、南洋理工等 30 位研究者联手厘清具身数据金字塔
7 月 28 日,来自北京大学、南洋理工、港科大、新加坡国立、港大、上海交大等十余所机构的近 30 位研究者联合发布了一篇 72 页长文综述《Data Pyramid for Embodied Manipulation》。该综述通过一个五层…
0.04B 通吃异构相机,与地瓜机器人隋伟谈 X-Lens 取舍逻辑
鱼眼相机看得广但画面边缘是畸变弯曲的,针孔相机看得直但视野窄。 一台机器人身上往往同时挂着这两种相机,用于感知环境深度,而像 DAC、MapAnything 等深度估计模型,几乎没有既能同时适配好这两种相机,又能端侧跑起来的方案。 对此,地…
KEMO:给 VLA 装上「记忆插件」,长程任务性能提高 23.6%
2026 年 6 月 17 日,成立于 2024 年的机器人训练基础设施初创公司 XDOF 解除低调状态,完成 7,000 万美元融资,投资方包括 Thrive Capital、 Spark Capital 等一众知名投资机构。 几乎在完成…
宇树风波背后,英伟达的新算力生意
在 GTC 2026 期间,英伟达发布了面向学术研究的 Isaac GR00T Reference Humanoid Robot 。按照公开信息,这套参考设计采用宇树 H2 Plus 人形机器人本体,搭载 NVIDIA Jetson AGX…
从底层本能出发,橡木果机器人发布「本能驱动」技术路线
6 月 2 日,橡木果机器人发布「本能驱动」技术路线,从底层本能出发,让机器人先获取操作本能,继而在与物理世界的交互中自主涌现操作智能。 从行业视角看,目前具身智能领域多数公司选择的是「自上而下」的路径:用大模型理解任务,用海量数据训练端到…