

表征
共 44 篇相关内容

对话 Copper-Policy 团队:从像素预测走向紧凑世界表征
为了让机器人具备更强的认知与物理交互能力,研究者开始探索世界动作模型(WAM)。WAM 通过视觉动力学预测场景的演化,将「世界应当变成什么样」与「机器人如何实现这一变化」联系起来。即使测试时不生成未来,联合训练的收益仍然存在。 那么,WAM…

上海交大、创智学院、穹彻智能联合发布 UniFlowWAM: 当「流」成为模态
上海交大、创智学院、穹彻智能联合发布 UniFlowWAM: 当「流」成为模态 近半年来,有关 WAM 的研究越发出现一种趋势,即将物理世界的信号提取为抽象模态,成为数据并进入编码器中,用于具身模型的学习。积水成冰,随着越来越多的团队叩问什…
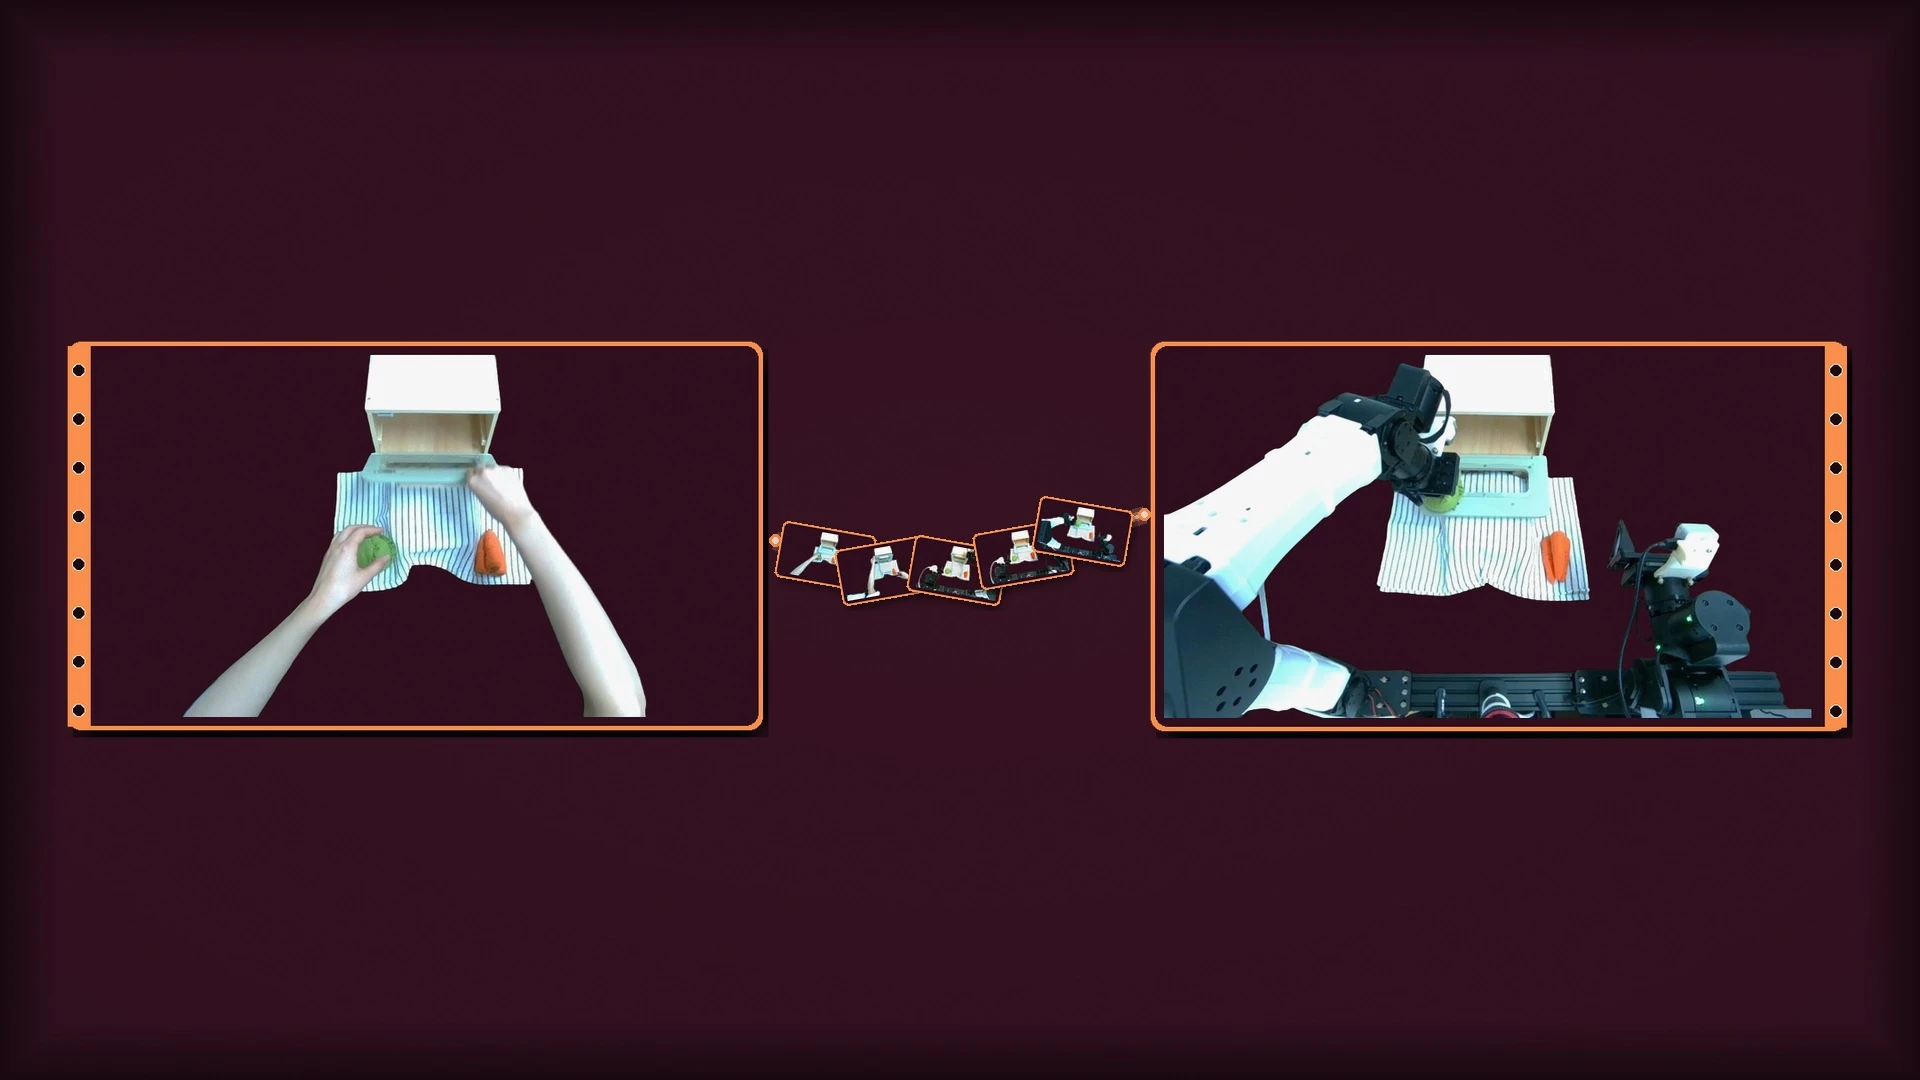
英伟达提出 ThinkWorld,把动作写成链,用想象的未来判对错
机器人演示采集成本高,覆盖的场景和动作有限。互联网上虽然有大量人类第一视角视频,却零散杂乱,也没有机器人可以直接执行的动作标签。VLA 怎样吸收这些视频里的操作经验? 针对这个问题,英伟达联合 KAIST(韩国科学技术院),于 10 月 2…
谷歌发布 Genie 4,Genie 系列首次原生生成音频
北京时间 10 月 28 日凌晨,谷歌 DeepMind(Google DeepMind)在官方博客发布新一代世界模型 Genie 4,谷歌官方博客同步发文介绍,谷歌 CEO Sundar Pichai 同时在 X 上发帖宣布。能实时交互、…
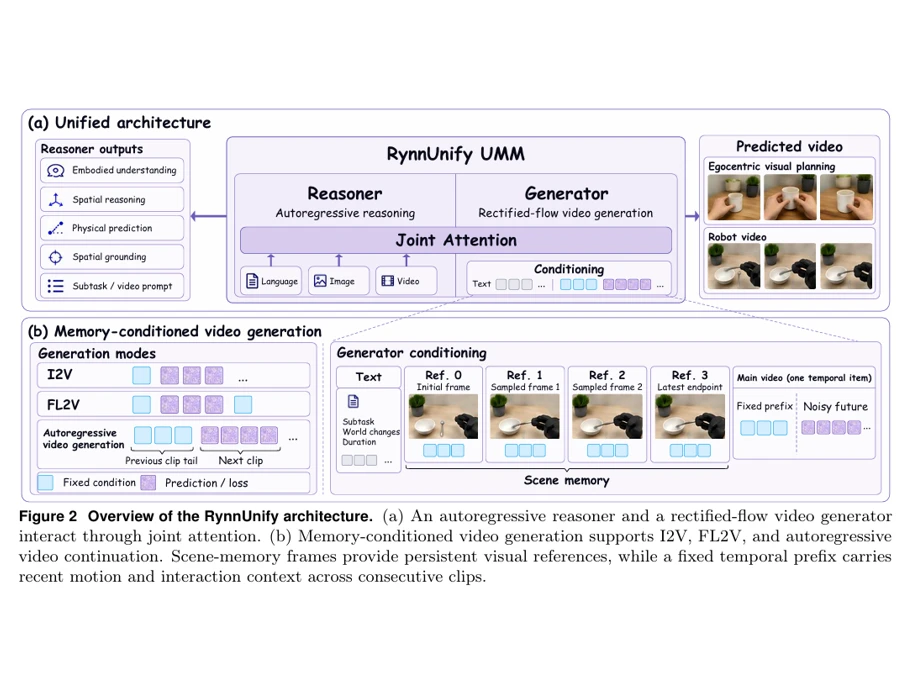
8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑?
主:8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑? 副:大模型,开始用视频打草稿 小红书正文 对于机器人来说,脑补被遮挡的物体实在太难了。10 月 23 日,阿里巴巴达摩院团队联合湖畔实验室发表论文《迈向统一具身大脑》(…
SharpaDex v1.0 正式开源:发布约 300 小时真实触觉操作数据,覆盖 59 种任务
10 月 22 日,Sharpa 正式开源灵巧操作数据集 SharpaDex v1.0。该数据集包含约 300 小时真实机器人操作数据、28,993 条示教和 32,396,172 帧数据 ,覆盖 59 种操作任务。根据 Sharpa 官方…
具身智能前沿取得重大突破!SuperMimic 或为机器本体扫清算力障碍
10 月 21 日,加州大学伯克利分校(UC Berkeley)团队公开论文《SuperMimic: Scaling Humanoid Whole Body Control with One Differentiable World Mod…
仉尚航等提出 HAF-VLA,让人形机器人分层生成协调的全身动作
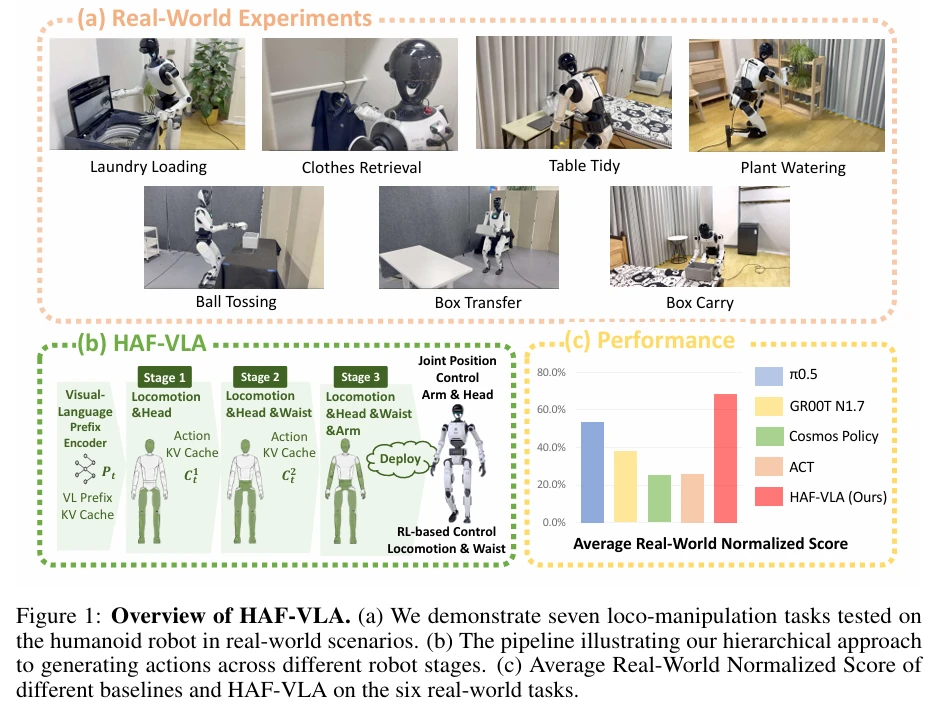
仉尚航等提出 HAF VLA,让人形机器人分层生成协调的全身动作 人形机器人要学会自主走向目标、俯身、再伸手抓取,卡点在于全身动作的协同生成。腿、腰、头部与双臂串联在同一条运动学链上:底盘偏移几厘米、腰部角度差几度,手臂就得伸得更远代偿。持…
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
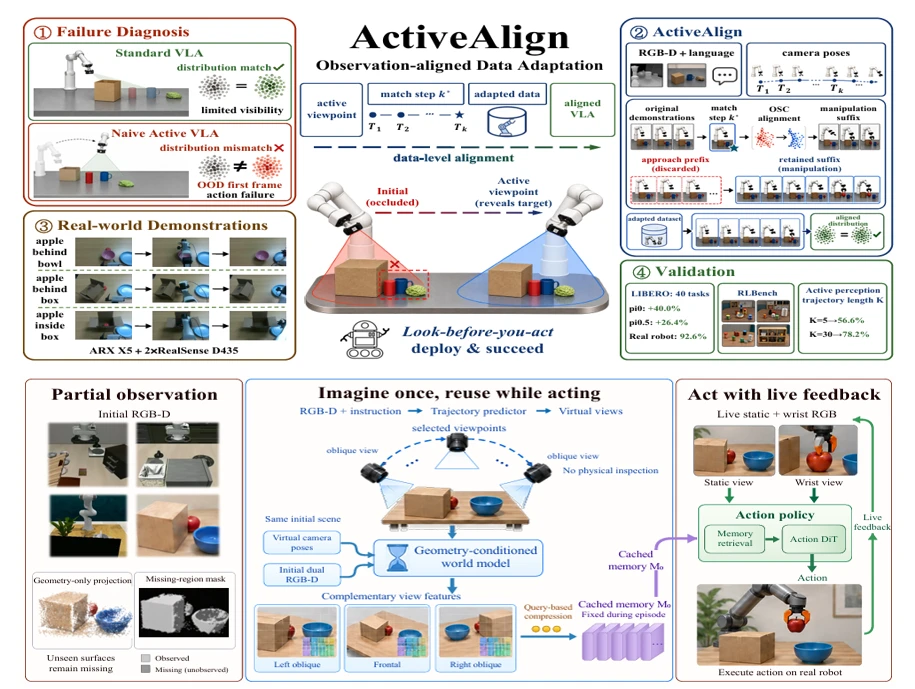
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作 机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关…
清华系创业公司新作:机器人看了 100 万小时人类操作,学会自己想办法
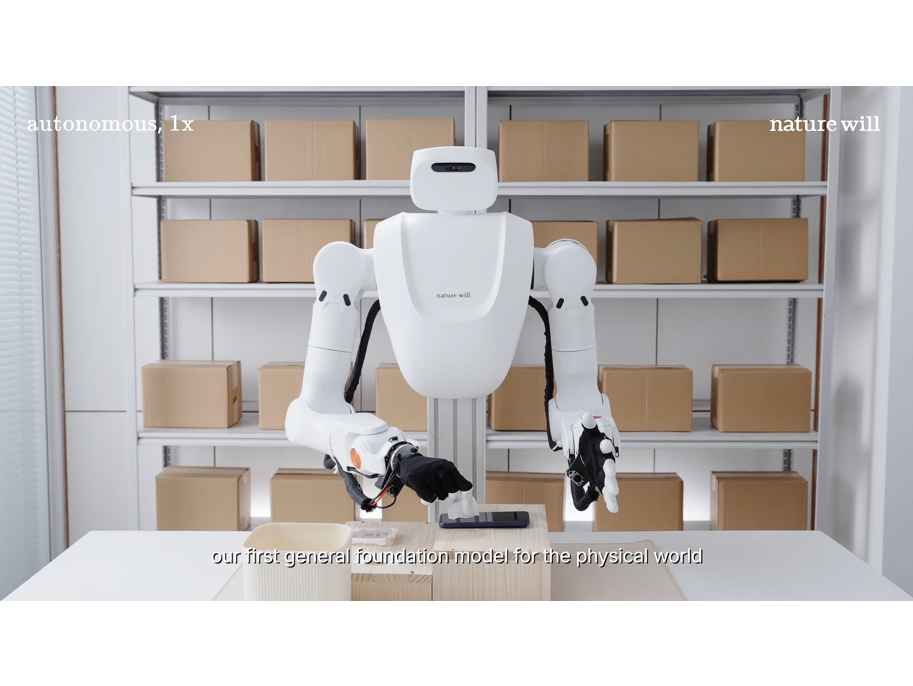
螺丝、包装袋、瓶盖,这些日常物件全都是为人手设计,但机器人的末端执行器大多还停留在两指夹爪。想要打造能在真实世界落地的通用机器人,灵巧手操作是绕不开的一关,而真正的瓶颈在于操作经验。通用模型需要见过足够丰富、大规模的真实操作样本,可机器人只…
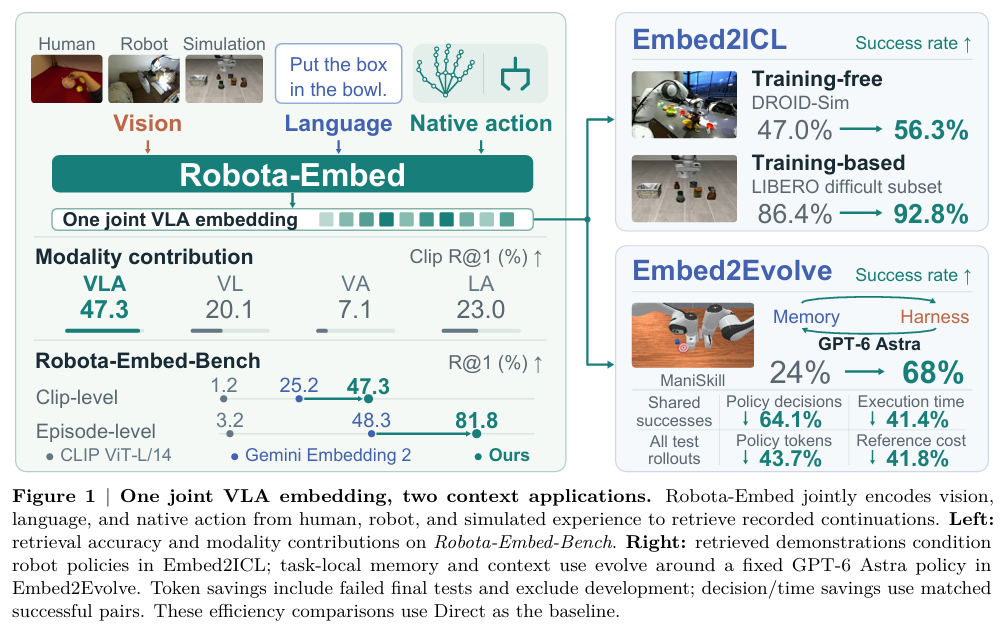
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
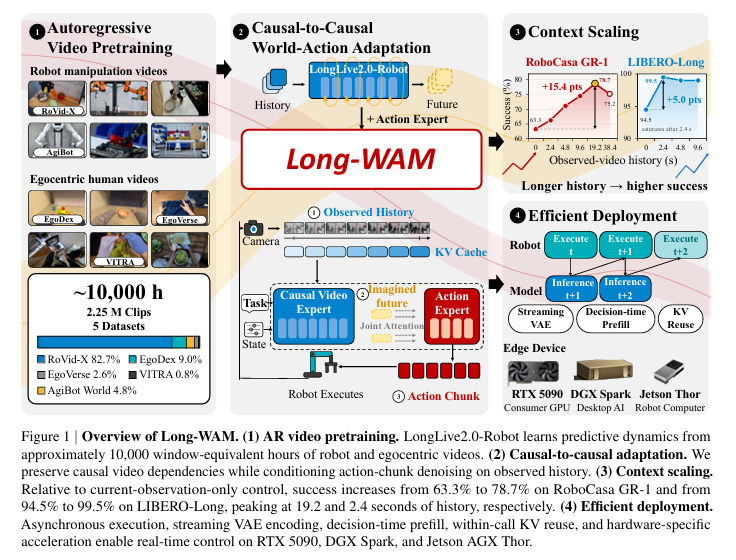
英伟达 Jim Fan 团队新作:只拉长历史解决不了 WAM 短板,核心需靠自回归预测
Long WAM 发现「能拿到历史」不等于「会用历史」:只有视频底座先以自回归方式学会从过去推未来,拉长上下文才能真正实现性能上涨。基于这一结论,团队将这套世界动作模型打造为可在边缘设备实时运行的系统。上下文时长从 0 秒拓展至 19.2 …