

谷歌发布 Genie 4,Genie 系列首次原生生成音频
作者:江思奇
北京时间 10 月 28 日凌晨,谷歌 DeepMind(Google DeepMind)在官方博客发布新一代世界模型 Genie 4,谷歌官方博客同步发文介绍,谷歌 CEO Sundar Pichai 同时在 X 上发帖宣布。能实时交互、自带声音的模拟世界,离训练机器人还有多远?
Genie 4 目前以研究预览形式向受信任测试者开放。据谷歌官方博客介绍,Genie 4 即将向 Project Genie 中的 Google AI Ultra 订阅用户开放,同时开放给 Gemini API 和 Google AI Studio 的早期合作伙伴,用户可以在 Project Genie 中加入候补名单。DeepMind 博客署名作者为 Raia Hadsell、Diego Rivas 和 Hang Qi。
Genie 4 的底层能力来自 Gemini 系列模型。据谷歌介绍,Gemini Omni 负责让模拟场景在外观和行为上贴近真实世界,其他 Gemini 模型提供复杂推理,用来维持模拟的连贯性和连续性。用户先设定一个事件,Genie 4 会模拟接下来发生的事,包括世界如何响应、听起来是什么声音,以及场景中的人如何移动、反应和说话。
在交互方式上,用户用标准键盘控制移动和镜头,并可以随时输入文字指令改变场景,例如切换天气、移动镜头、加入新的人物或物体。据谷歌介绍,Gemini 会根据周围场景调整用户的指令,两次输入之间 Gemini 也会持续监控并引导场景,让世界按连贯的方向推进。
音频是 Genie 4 新增的能力。据谷歌介绍,Genie 4 是 Genie 系列中首个原生生成音频的实时世界模型,每个生成的世界都会带有与环境匹配的环境音,例如林间的风声和海浪拍岸声,也能生成音乐。Genie 4 还加入了可实时变化的对话,场景中的人物会根据用户输入或世界中的事件交谈和反应。谷歌在博客中注明,演示视频里的所有声音都由 Genie 4 直接生成。据 TechCrunch 报道,Runway 在几个月前发布的第二代世界模型 GWM Worlds 2 同样能实时响应用户输入并生成音频。
物理和人物动作的真实感是这次的另一项重点。据谷歌介绍,Genie 4 基于对物理世界的理解,可以模拟空气动力学、碰撞等真实物理场景。谷歌称,变化最大的是对人的模拟,生成的人物动作自然,会对环境做出反应,并且可以被实时操控。官方演示中包括西瓜被砸、枫树种子从树上旋转落入草地等场景。
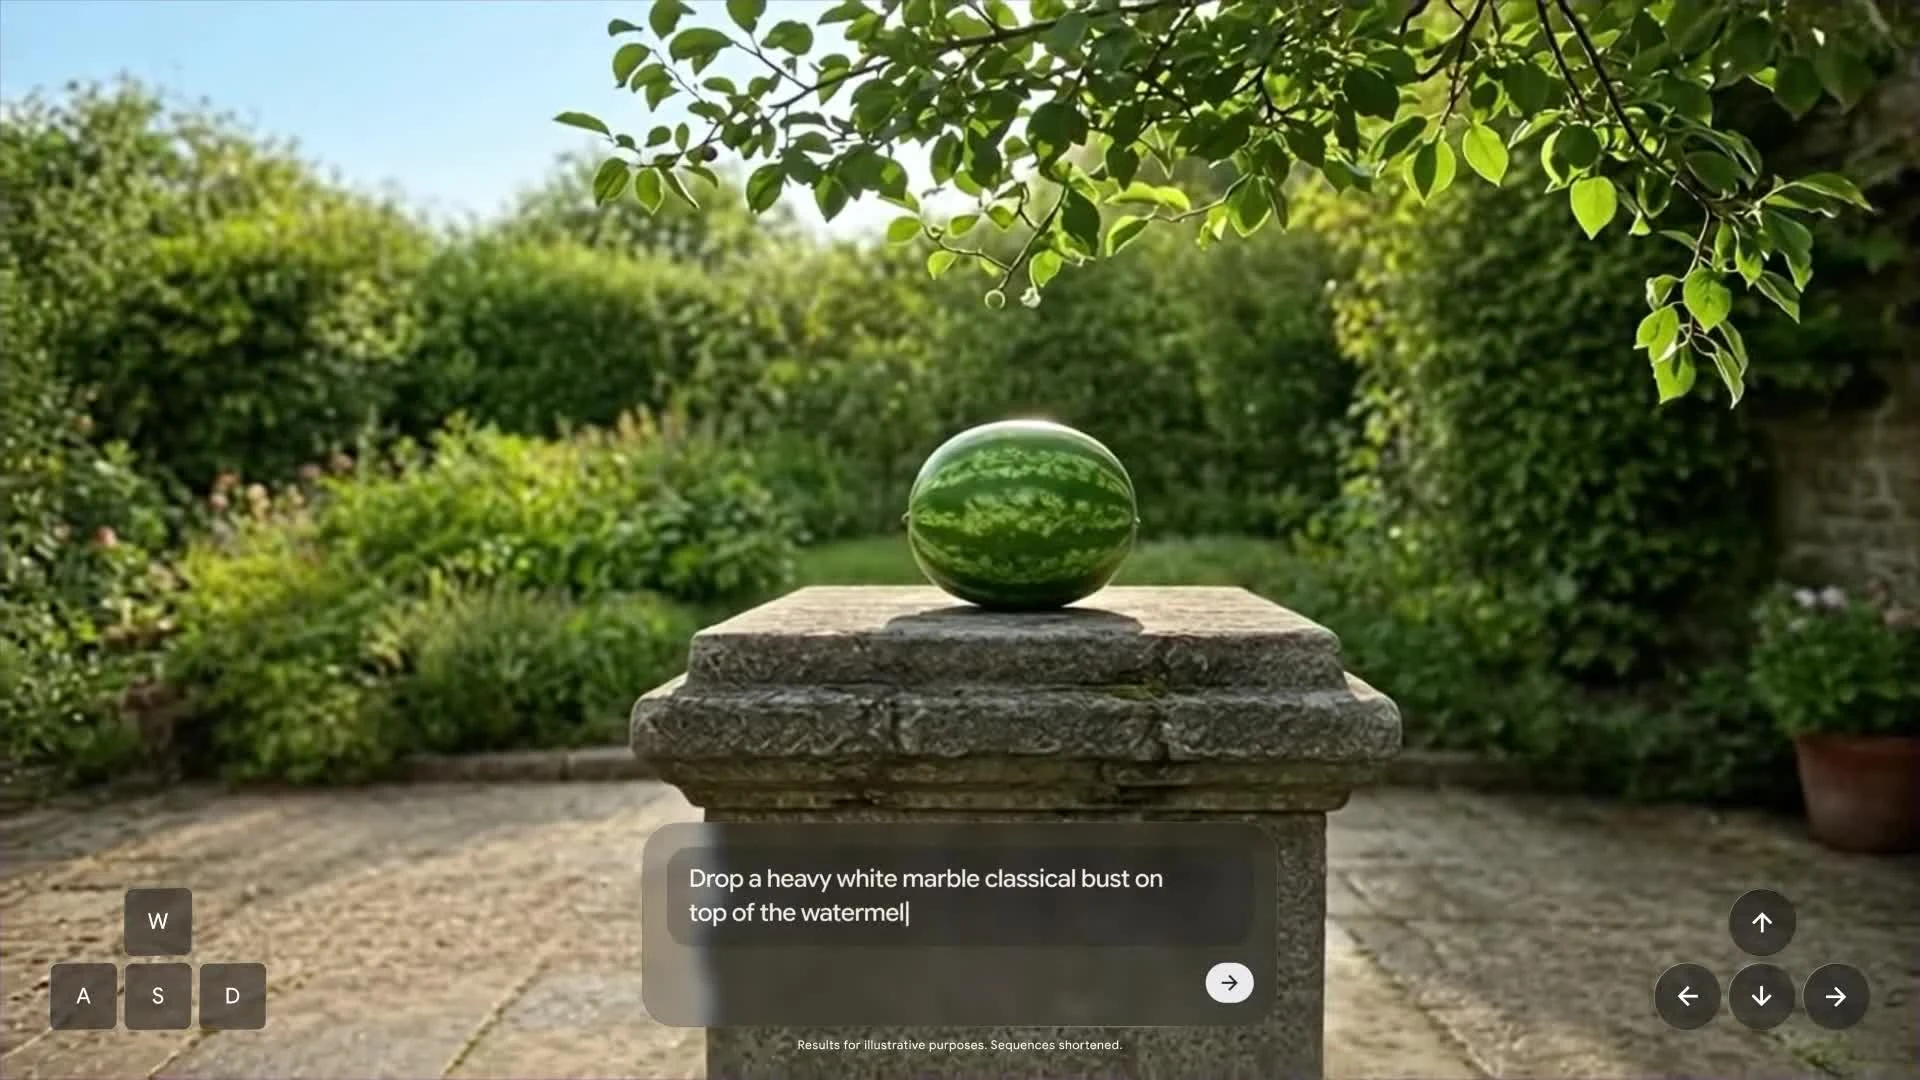
图丨用户输入指令后,Genie 4 模拟大理石胸像砸向西瓜的场景(来源:谷歌 DeepMind)
Gemini 与 Genie 4 的结合用于模拟多步骤的复杂事件。据谷歌介绍,Gemini 3.8 Flash 在其中充当「循环中的引导智能体」:Genie 4 实时生成世界时,Gemini 持续观察画面,把目标拆成一系列步骤,并检查新生成的画面,追踪进度、确认每一步是否完成。
世界发生变化或用户介入时,Gemini 会当场调整计划。谷歌表示,这让模拟世界具备可靠的因果关系、程序化行为和多步推理能力,也可以在 AI 系统进入真实世界前,测试它们如何应对不同环境。官方演示之一是 Universal Robots UR5 机械臂手持移液器向实验板中滴加液体。
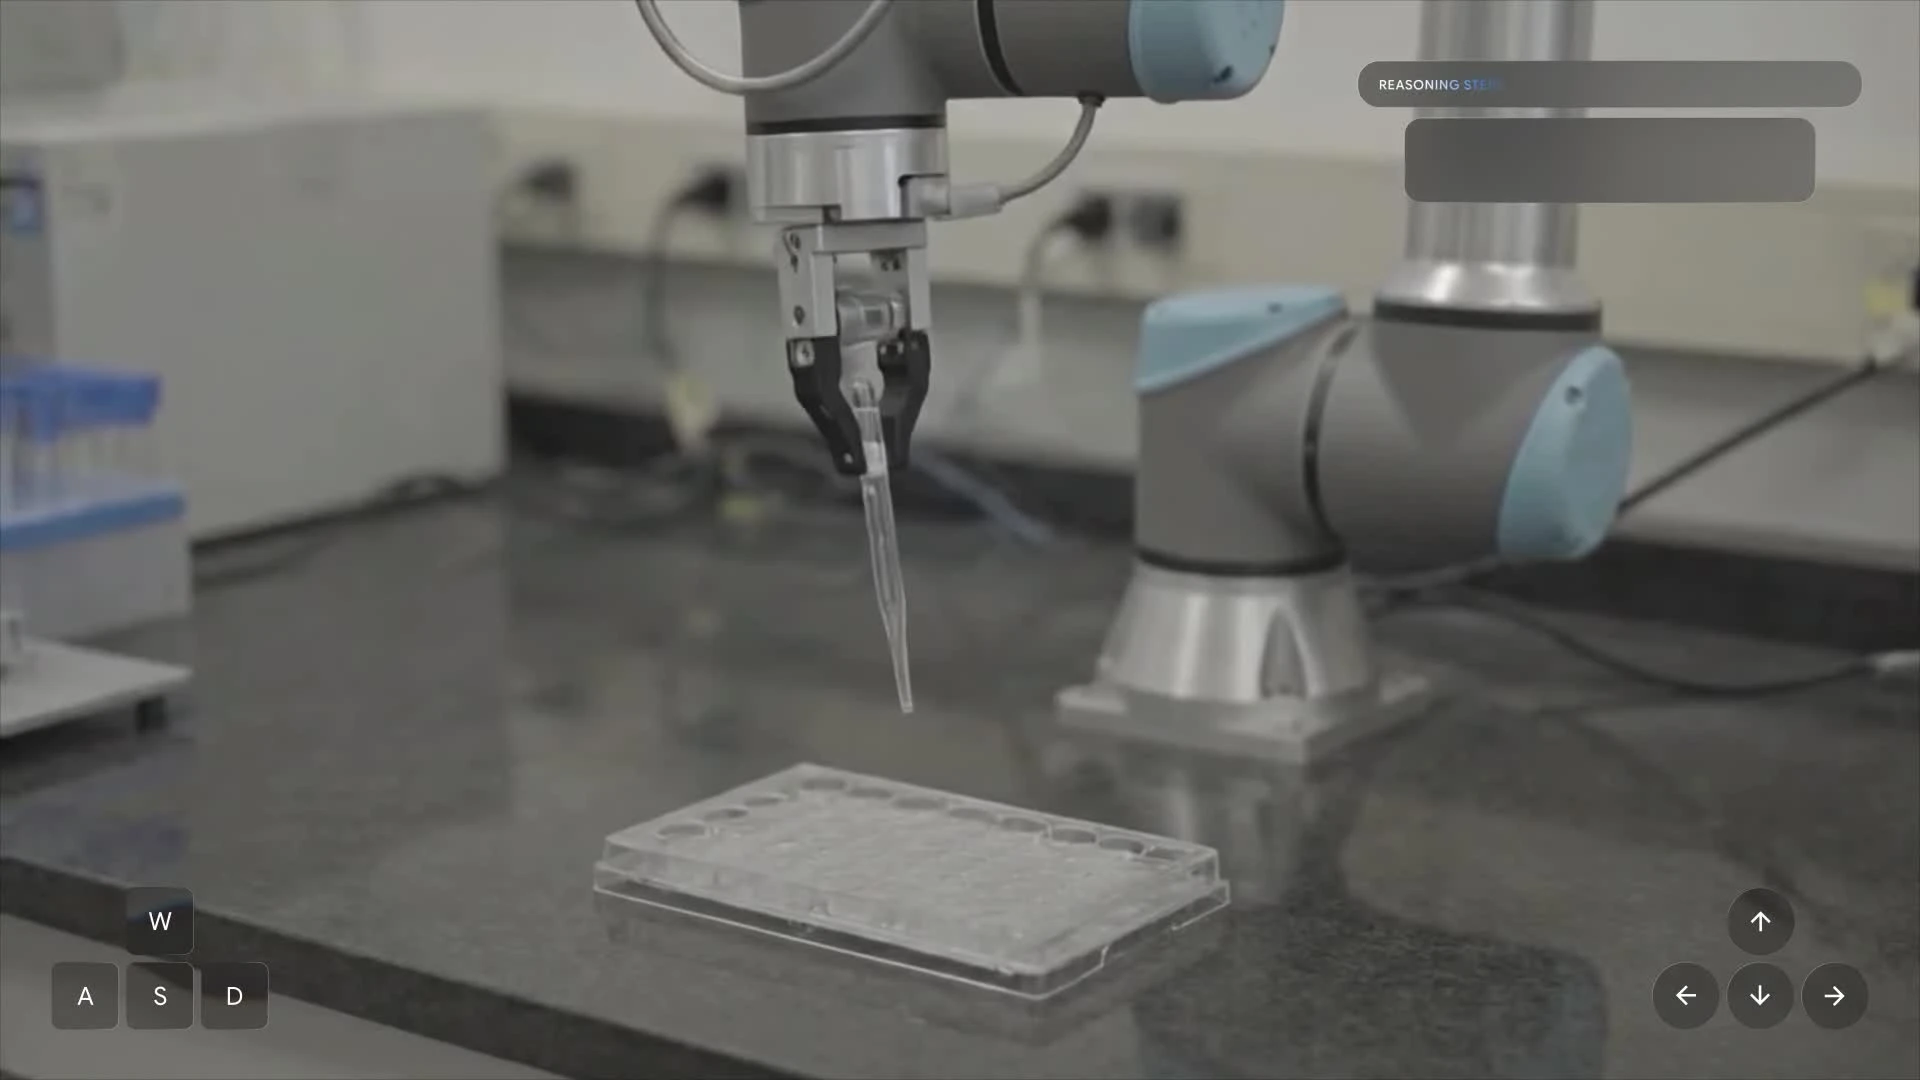
图丨Genie 4 模拟 UR5 机械臂用移液器向实验板滴液(来源:谷歌 DeepMind)
机器人方向,谷歌正在把 Gemini 4 Argon、Genie 4 与 Gemini Robotics 的研究结合起来。据谷歌介绍,在一个实验中,Argon 把用户布置的任务拆成若干步骤,以文字描述的形式在模拟渲染过程中逐步交给 Genie 4,模拟可以随任务推进实时调整。
演示视频中,两者配合模拟了 Apptronik 的 Apollo 人形机器人下跳棋。谷歌称,这为在想象的世界中模拟大量场景提供了一条路径,官方模型页将其称为机器人仿真的「无限游乐场」。
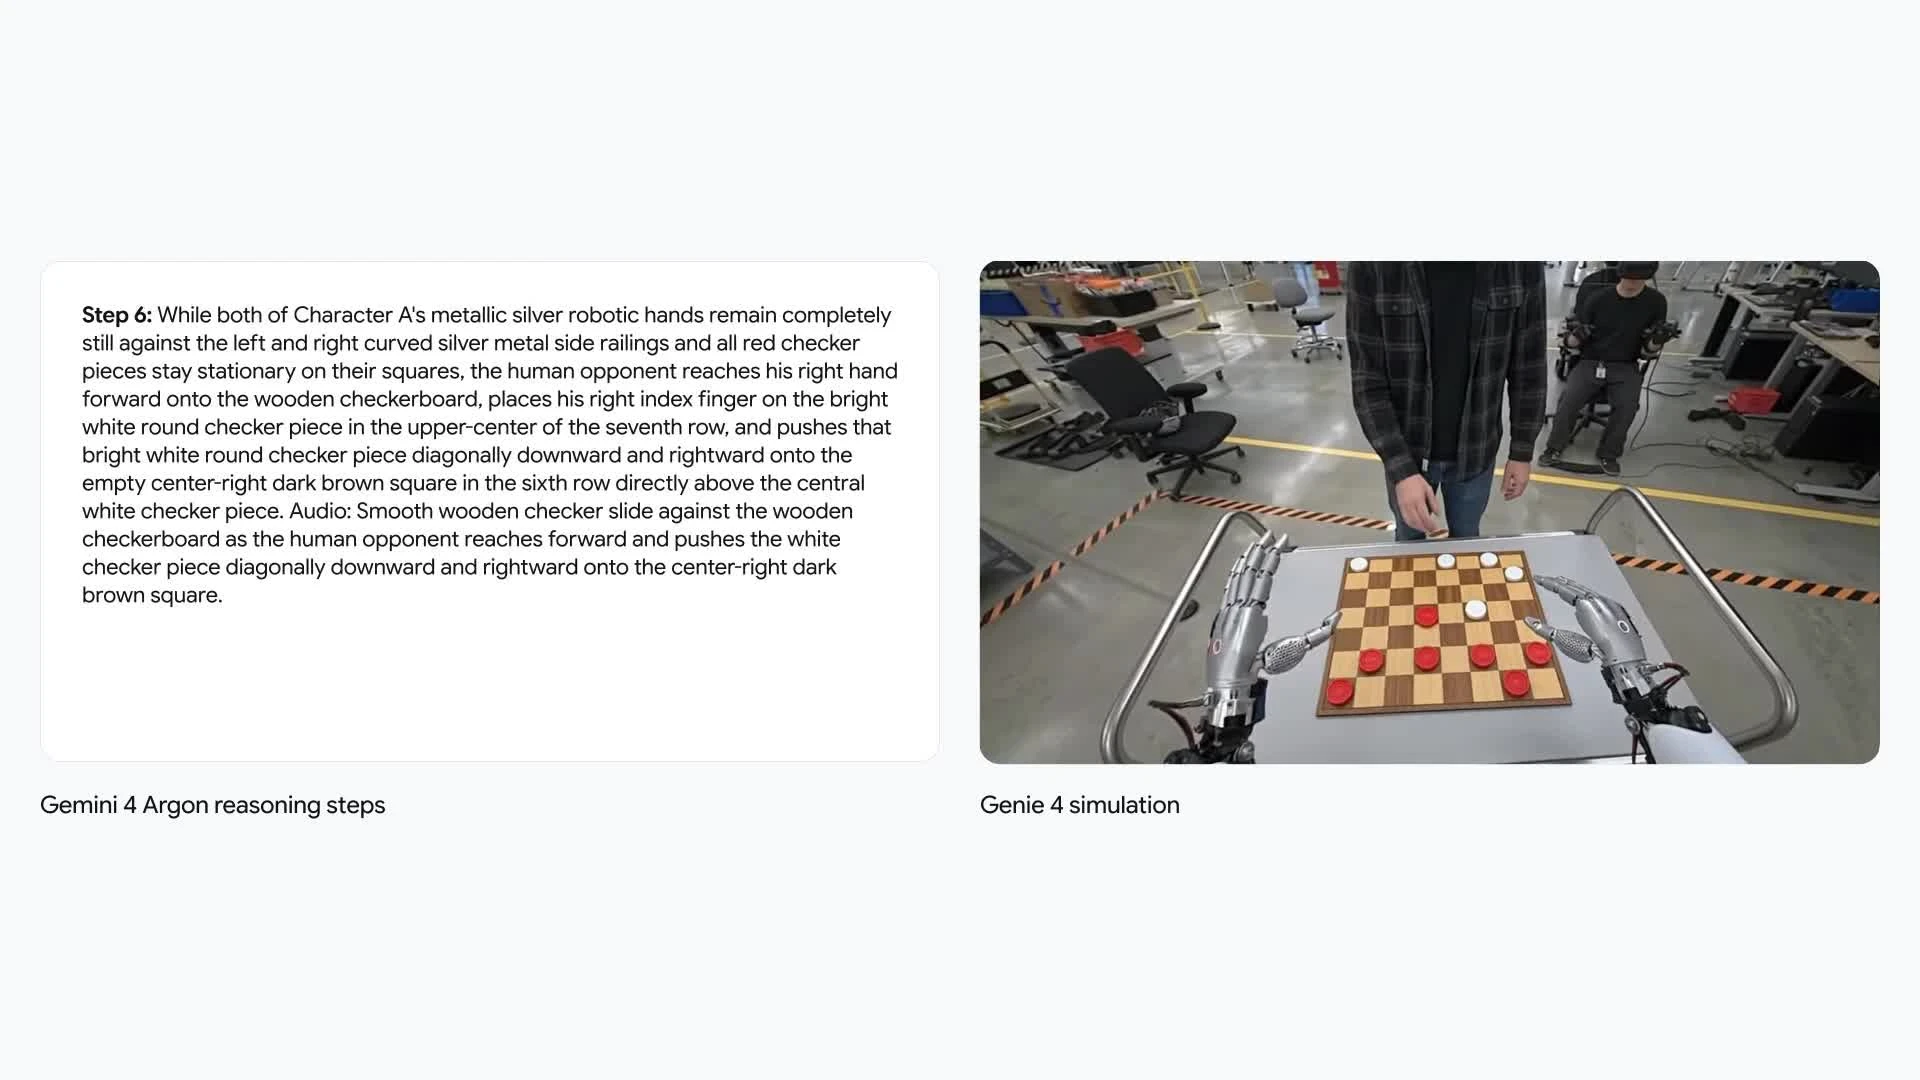
图丨左侧为 Gemini 4 Argon 拆解出的推理步骤,右侧为 Genie 4 模拟的 Apollo 人形机器人下跳棋(来源:谷歌 DeepMind)
Genie 4 的机器人示例由文字驱动。据谷歌 DeepMind 模型页介绍,Gemini 4 Argon 先为任务制定多步计划,再在模拟渲染过程中把步骤以文字描述的形式交给 Genie 4。机器人领域的另一类世界模型以动作作为输入条件。
据 1X 介绍,其世界模型用 EVE 人形机器人在家庭和办公室中采集的数千小时视频和动作数据训练,从同一组初始画面出发,可以根据不同的动作指令生成不同结果,用于评估机器人策略。
据 Meta 介绍,V-JEPA 2 先用超过 100 万小时视频和 100 万张图片做无动作预训练,再用 62 小时机器人数据做以动作为条件的训练,预测结果输出在表征空间中,可用于零样本机器人规划。
据英伟达介绍,Cosmos 3 可以根据文本、图像、视频、环境声音和动作输入生成未来画面,并可作为机器人策略学习中「世界动作模型」的基础模型。在谷歌目前公开的页面中,Genie 4 的输入为键盘操作和文字指令。
谷歌在博客中表示,理解和模拟世界是构建 AGI 的关键一环,Genie 4 可以生成安全、可无限变化的模拟环境,用于为机器人和智能体搭建训练环境,也可用于创作新的交互体验。据谷歌介绍,除机器人研究外,多个行业的企业合作伙伴正在评估用 Genie 4 快速生成从零开始的场景。受信任测试者还来自创意、新闻、教育、游戏和工程领域,有影视团队把它用于预演,摄影记者尝试把一张历史照片变成可交互的模拟环境。
谷歌也列出了 Genie 4 目前的局限。据谷歌介绍,Genie 4 能在较短时间内保持环境连贯,但随着模拟时间变长、多次复杂指令修改或在场景中移动,画面细节和物体恒存性仍可能发生漂移。复杂物理交互、实时音频的准确性、文字清晰渲染、空间准确性和长期一致性仍在研究中。谷歌官方模型页写明,模型可支持「几分钟」的连续交互,不支持长时间会话,没有给出具体时长。
据 The Verge 和 TechCrunch 报道,Genie 4 的场景最长可保持约两分钟,是 Genie 3 的两倍。Genie 4 生成的所有视频和音频都会带有谷歌的 SynthID 数字水印。