

30 次真机任务测试 27 次达标,北大董豪团队让灵巧手换个握法
作者:江思奇
灵巧操作最棘手的难点,在于手该以何种姿态与物体接触。同一个杯子,抓杯沿、握把手、托杯身,即便物体最终位姿完全一致,操作稳定性、能否衔接后续动作也天差地别。
针对这个问题,11 月 3 日,北京大学计算机学院前沿计算研究中心、多媒体信息处理全国重点实验室、启元机器人与北京通用人工智能研究院团队发表论文《DexHOT: Learning Hand–Object Configuration Transfer for Dexterous Manipulation》(用于灵巧操作的手—物构型转移学习),研究提出 DexHOT —— 一套把手与物体的相对关系纳入优化目标的灵巧操作框架,把学习对象从单一物体状态,转变为手 – 物配对构型。
论文共 7 位作者,Zhewei Gui 与 Anthony Bolton 为共同第一作者,Jiyao Zhang 为项目负责人,北京大学计算机学院前沿计算研究中心长聘副教授、启元机器人首席科学家董豪为通讯作者。
团队的研究思路跳出了传统范式:即不再单独优化物体姿态,而是从手 – 物构型本身出发,尝试只用合成构型对学到可复用的局部转移能力,再拼接完成长时序操作。
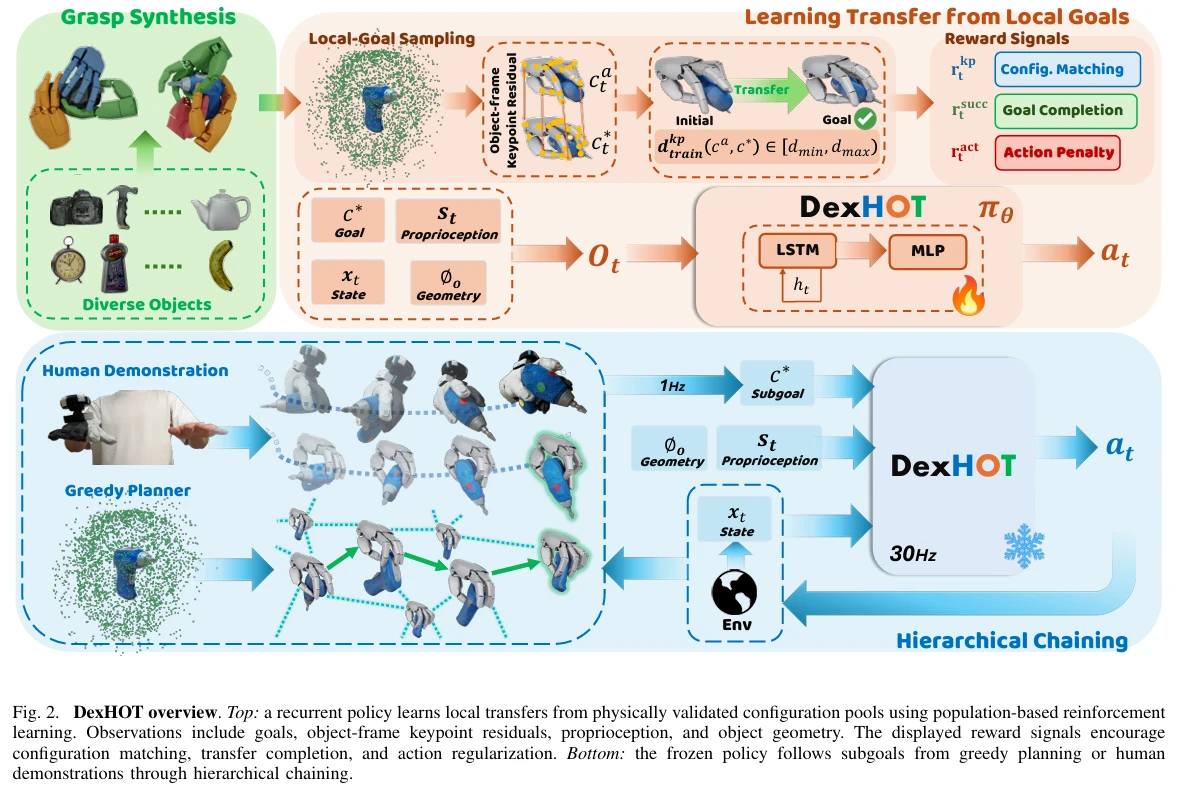
DexHOT 的实现分为四个核心模块:
- 构型表征与距离度量:将手 – 物构型定义为手指关节角 + 物体相对手腕的位姿;采用 28 个手部关键点在物体坐标系下的平均位移作为距离指标,把两类异质信息统一为毫米尺度。
- 共享策略训练:从 40 个物体构成的可行构型池中选取邻近目标,训练跨物体通用的循环策略,并通过 64 个种群的探索扩充行为空间。
- 长距离贪心规划:执行远距离操作时,由贪心规划器选取中间过渡构型;子目标以 1 Hz 更新,手部策略以 30 Hz 跟踪执行。
- 示范引导接入:接入人类示范场景时,直接使用与示范对齐后的构型作为子目标。
在自建基准 DexHOTBench 上,该策略在 40 个训练物体上平均成功率 80.5%,80 个未见过的留出物体为 69.4%;真机 200 次构型转移成功率 61.5%,六项示范引导任务 30 次测试完成 27 次。
这套方案能否稳定支撑更长的操作流程,仍有两个关键问题待验证:
一是短距离习得的转移能力的有效作用上限;
二是手部策略和外部规划、人类示范如何合理分工,避免模块间相互牵制。
手部摆放,直接写进目标
DexHOT 重新定义了灵巧操作的优化目标,整套流程分为四步:先对「手与物体的相对摆放状态」做形式化表征,再给出构型之间的距离度量,将距离纳入策略观测,最后通过一连串子目标,把短距离的局部转移拼接成长距离操作。
第一步,定义手 – 物构型。设手腕坐标系为 W,物体坐标系为 O,单个构型由 22 维手指关节角,搭配物体在手腕坐标系下的六维位姿共同描述。目标构型同时约束手指姿态,以及物体相对手腕的位置与朝向。
第二步,设计构型距离度量。团队将构型映射至物体坐标系下的 28 个手部关键点,包含掌心参考点、22 个指节原点以及 5 个指尖点;两个构型之间的距离,取这组关键点位移的平均值,单位为毫米。该度量只刻画手与物体的相对关系,不受这一整套手物组合在世界坐标系下平移、旋转的影响。
这也是整套方法能够成立的核心:手指关节角、物体六维位姿属于两类异质量,原本无法直接比较;借助 28 个关键点映射到同一三维空间,策略才有统一指标,用来衡量短距离调整的进展。
这些关键点仅作为运动学参考,并不强制对应实际接触点。而一个构型需要同时满足三项约束才算可行:能够稳定承托物体、不存在穿模、处于便于后续操作的可达空间内。
第三步,构建面向构型跟踪的条件策略。策略输入当前构型、本体状态、物体粗略形状描述以及子目标,输出 22 维手部动作;同时预留 6 个手腕控制通道,实验中并未启用。动作以固定步长叠加至关节位置指令,并截断在关节限位之内。一次转移判定成功的标准:构型距离收敛至 20 mm 以内,并连续维持 10 个控制步,全程不能脱落。
第四步,串联多段短转移。给定远端目标后,贪心规划器持续从构型池中筛选候选构型,要求候选与当前构型距离不超过 50 mm,且更靠近最终目标;选中的构型作为子目标,以 1 Hz 更新,手部策略则以 30 Hz 闭环跟踪。若无法直达目标,规划器会扩大搜索范围重新寻找过渡节点。
这套分层方案只保证首尾过渡构型本身可行,不预设每一段路径在动力学上天然通顺;中途的手指调整、换指、重抓都交由策略在闭环中自主生成。规划负责拆解长距离任务,策略负责局部运动执行,各司其职,避免让单一策略直接学习高难度的长时序操作。
目标范式确定之后,训练环节才是真正的难点:单条策略需要在 40 个物体、数十万组初态 – 目标配对上,同步学习构型转移能力。
构型池搭建,种群探索训练
整套训练流程同样分为四步:先收集所有可行构型,构建构型池;再从池中选取邻近目标,学习短距离构型转移;接着打通观测、奖励与动作接口;最后借助种群机制拓宽策略的行为覆盖范围。
第一步,构建合成构型池。团队从 Omni6DPose 的 40 个类别中各选取一个物体,依托 BODex,在物体表面采样初始种子,针对不同物体朝向同步优化整手抓取与指尖抓取,产出预抓取、抓取、挤压三类姿态。所有候选构型送入 Isaac Gym,依照训练用物理参数与碰撞几何校验,剔除穿模、无法稳定承托物体的样本,最终得到 82.5 万个构型,按物体划分独立训练池子。
第二步,采样局部训练目标。为每个构型锚点预先计算邻域,仅保留距离在 20–40 毫米区间内的目标;距离小于 20 毫米的样本直接舍弃,该范围已经落入评测成功容差。一轮训练从池中随机选取锚点构型起步,在它的预计算邻域内采样目标;完成一次转移后,该目标自动成为新锚点,同时尽量避免重复选用近期目标,发生物体脱落或超时则重置回合。整套邻域为离线预计算,训练阶段无需实时检索。
第三步,对接观测与动作接口。目标采用关节角搭配 28 个关键点残差编码;物体形状由 64 维基点点集表征,额外补充四个包围盒关键点,分别在当前手腕坐标系与目标手腕坐标系下表达。奖励由三部分构成:随关键点距离缩小逐步递增的塑形奖励、达成目标后一次性发放的 100 分完成奖励,以及系数 0.02、基于动作绝对值总和的幅度惩罚。训练后期额外增加远端关节过度弯曲惩罚,约束手指姿态向目标构型靠拢。
第四步,种群式探索。单独的 PPO 策略在海量初态 – 目标配对下,容易收敛到有限的少数转移模式。为此团队采用 EPO:设置 64 个探索单元共享同一套网络权重,每个单元携带一条 32 维可学习隐变量。遗传更新环节保留表现最优的精英单元,其余单元的隐编码通过精英交叉与高斯变异生成;适应度依据单位控制步内完成的转移数量评估,和策略梯度所用回报相互独立。
训练配置规模如下:策略网络由一层 1024 维 LSTM 叠加四层 MLP 构成;价值网络采用非对称结构,可以获取无噪声的关节、指尖、物体速度以及接触信息,策略与价值网络均接入探索单元的隐变量。并行环境总数达到 52.4 万,物理仿真频率 60 Hz,控制频率 30 Hz。随机化范围包含物体质量、尺寸、摩擦、恢复系数,手部摩擦、连杆质量、关节刚度与阻尼;同时引入随机外力、观测噪声、0–2 步控制延迟,重力系数从 0.2 逐步升温至 1。
这套配置的核心在于种群探索。即便开启数十万并行环境,单一 PPO 依旧容易局限在少量换手策略里;依靠 64 个探索单元配合遗传更新,才能够充分拓展行为空间。部署阶段仅保留单个单元:在全部 64 个单元里筛选实测成功率最高的一支,冻结共享权重与其对应的隐变量即可。
策略训练完成后,还需要验证:它真正学习到的是通用的手 – 物构型规律,换到陌生物体上也能复用。
一百二十个物体,验证泛化能力
团队的验证分为三部分:搭建评测基准、在仿真中测试成功率随距离与物体的变化规律,再通过消融实验逐一验证各个训练组件的必要性。
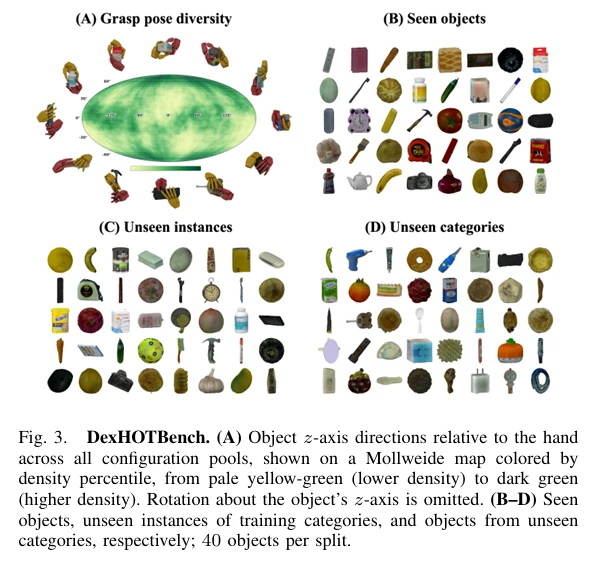
基准结合 Omni6DPose 的类别划分与 UniDexGrasp 的新颖性规则构建,一共包含 120 个物体:其中 40 个用于训练,40 个是训练类别内未曾见过的新实例,剩余 40 个来自完全陌生的新类别。留出的 80 个物体全程不参与训练,每一个都按相同流程独立生成、校验构型池。全部 120 个构型池合计 118 万个构型,其中留出物体占 35.9 万个。物体尺寸设有约束:凸包包围球直径不超过 300 毫米,最小凸包厚度不低于 10 毫米,避免过薄网格引发穿模、拖慢接触计算。
评测样本按转移距离划分为三档:20–40 mm 的「邻近档」,对应训练时的采样区间;20–70 mm 为近距档,已经超出训练分布;70 mm 以上归为远距档。每个物体、每一档固定抽取 1000 组手 – 物构型配对,每组仅测试一次。评测统一使用贪心规划器,分配 20 次目标更新配额并按时重规划;网络配置、隐变量与规划参数在全部物体上保持不变。
训练集 40 个物体表现优异:邻近档成功率 90.9%,近距档 85.5%,远距档 75.6%,整体平均 80.5%。对于同类别的新实例,三档成功率依次为 88.3%、81.4%、67.3%,平均 74.4%;面对全新类别,则为 81.5%、72.2%、56.7%,平均 64.4%。
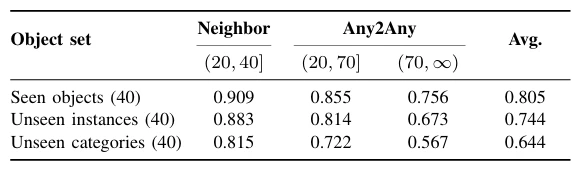
这组结果最关键的看点是性能衰减幅度:在同一距离档位下,从训练物体切换到全新类别,邻近档仅下滑 9.4 个百分点,远距档则下滑 18.9 个百分点,最难场景正是「陌生类别 + 大跨度构型切换」。
消融实验在 40 个训练物体上,沿用同一套评测协议。移除 EPO、改用单一 PPO 后,邻近档成功率仅剩 11.5%,近距档 2.5%,远距任务完全失败,整体均值仅 1.3%。如果放弃邻域采样,改为在整个构型池均匀随机选取目标,所有档位效果均出现下滑,平均成功率降至 68.2%,说明单纯见过远距离目标,并不代表模型掌握远距离转移能力。若把采样锚点由库内固定构型替换为实时当前构型,邻近档仍有 86.0%,但远距档跌到 52.8%,平均为 64.0%。
分距离档位的评测设计,把两个问题拆解开:一是模型能否稳定完成训练分布内的构型转移,二是学到的局部转移能力能不能向外泛化。目前这套基准暂无现成同类方法可以对照,核心支撑证据来自跨物体泛化结果与逐项消融。
仿真结果证明这套范式在虚拟环境下可行,但实际硬件上还能保留多少性能,需要真机实验进一步验证。
两百次转移,六项示范任务
团队在真机上分两轮开展验证:第一轮单独测试构型转移,手腕固定;第二轮沿用同一套策略,以人类示范给出的子目标驱动,完成一整套家务操作任务。
硬件平台采用一只 22 自由度 Sharpa Wave 灵巧手,搭载在 7 自由度 Franka Emika Panda 机械臂上。当前手 – 物构型依靠关节编码器结合 FoundationPose 重建,视觉输入来自一台第三人称布置的 Intel RealSense D435i。策略以 30 Hz 运行,全程不做真机微调。转移实验将手臂固定至掌心朝下的标准姿态,仅允许手指调整构型,以此单独考核灵巧手本身的操作能力。
转移测试选取 5 个见过、5 个未见过的物体,每个物体从构型池中抽取 20 组随机初态与目标,合计 200 次测试,每组仅尝试一回。实验流程为先复现初始构型,再向目标构型转移;成功判据沿用仿真标准:构型距离进入 20 mm 以内,并连续维持 10 个控制步、物体不脱落。同时额外统计进度指标,用来衡量预期距离缩减量里,最终稳定达成的比例。
200 次真机转移整体成功率为 61.5%,平均进度 0.735;见过与陌生物体的表现差距不大,分别为 63% 和 60%。分物体来看:网球 95%、药瓶 90%,卷尺、香蕉均为 80%,鼠标、手电筒 70%;洗发水瓶、面霜落在 45%,锤子、螺丝刀仅 20%。
失败集中出现在细长工具上,团队归纳为四类诱因:
- 打滑后无法自救:低摩擦物体一旦滑脱、发生自转,闭环控制器来不及修正;
- 初始构型复现偏差:依靠插值、挤压实现的抓取本身就处于临界稳定,真机起点就存在偏移;
- 中途运动阻滞:源于仿真与实物之间摩擦特性不匹配、手指侧向运动偏差或是碰撞几何不一致;
- 物体跟踪丢失:FoundationPose 偶尔失锁,导致无法获取有效的当前构型估计。
第二轮面向长流程任务,六项任务复用同一份冻结策略,每项任务配套一条重定向示范、五组固定初始状态。执行时先跟随示范轨迹抵达指定预抓取帧,随后手部控制权移交策略,手腕则由独立控制器继续跟随示范轨迹。自此之后,构型子目标以 1 Hz 从示范序列中提取,手部策略保持 30 Hz 闭环跟踪。
六项任务分别为扫码、上架、积木对位、摇晃盐罐、倒水、拧螺丝:扫码需要将瓶子旋转 180°,同时保证条形码露出、对准扫描设备;上架同样要转体 180°,还要从捏握切换为力量抓握;倒水需要把倒扣杯子摆正;拧螺丝则要把钻头朝下对准。
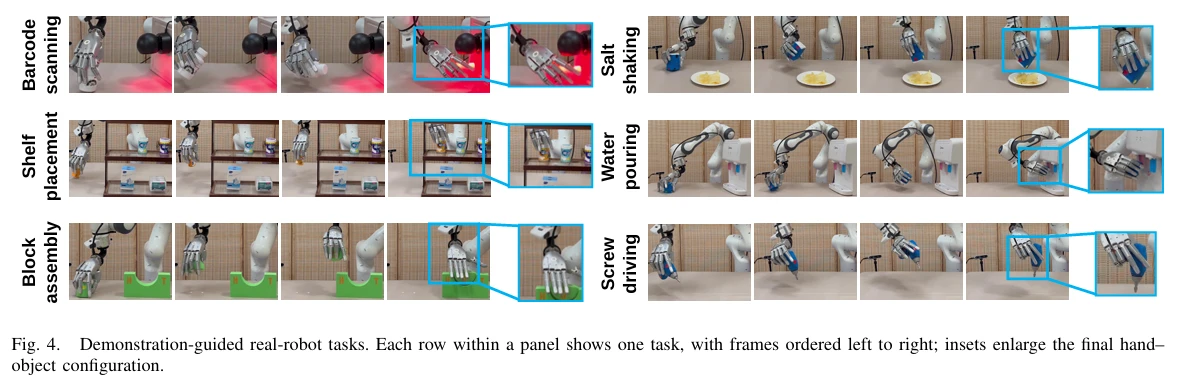
最终结果:30 轮测试里有 27 轮完整走完全部三阶段,任务完成率 90%。上架、积木对位、晃盐罐、倒水四项五次全部成功,扫码任务 4/5,拧螺丝 3/5。作为对照,仅做运动学重定向、单纯回放轨迹的基线,虽然有 24/30 能抓起物体,但后续手部构型序列完全无法跟上,全阶段通过率为 0/30;按传统物体目标改造的 SimToolReal,抓起成功率 21/30、物体姿态达标 9/30,仅有两次积木对位同时满足手部构型约束,全阶段仅 2/30。
这套评测最关键的设计是三段式打分:抓起、物体姿态达标、手 – 物构型达标各占一项。即便物体姿态到位,如果手掌遮挡条码,本轮依旧判定失败,以此量化「物体姿态目标」和「手 – 物构型目标」之间的本质差异。
DexHOT 将灵巧操作的优化目标,从单独的物体状态切换为显式的手 – 物配对关系:依靠合成可行构型对学习可复用的短距离转移,再通过规划器或是人类示范给出的子目标,拼接成长距离、多步骤操作。仿真中 80.5%、69.4% 的泛化成功率,真机转移 61.5% 的成功率以及示范任务 90% 的完成率共同证明,显式手 – 物构型是一套可用、可拆解、可接入外部引导的表达范式。
团队的核心结论落在构型这一层接口:它同时约束物体摆放与手部姿态,长流程里的重抓、接触切换都可以拆成一段段子目标接续执行。真机尚存的性能短板集中在细长工具、低摩擦接触面与视觉跟踪丢失,这也正是后续需要补齐动力学建模与感知能力的方向。