
 EN
真机实验
共 21 篇相关内容
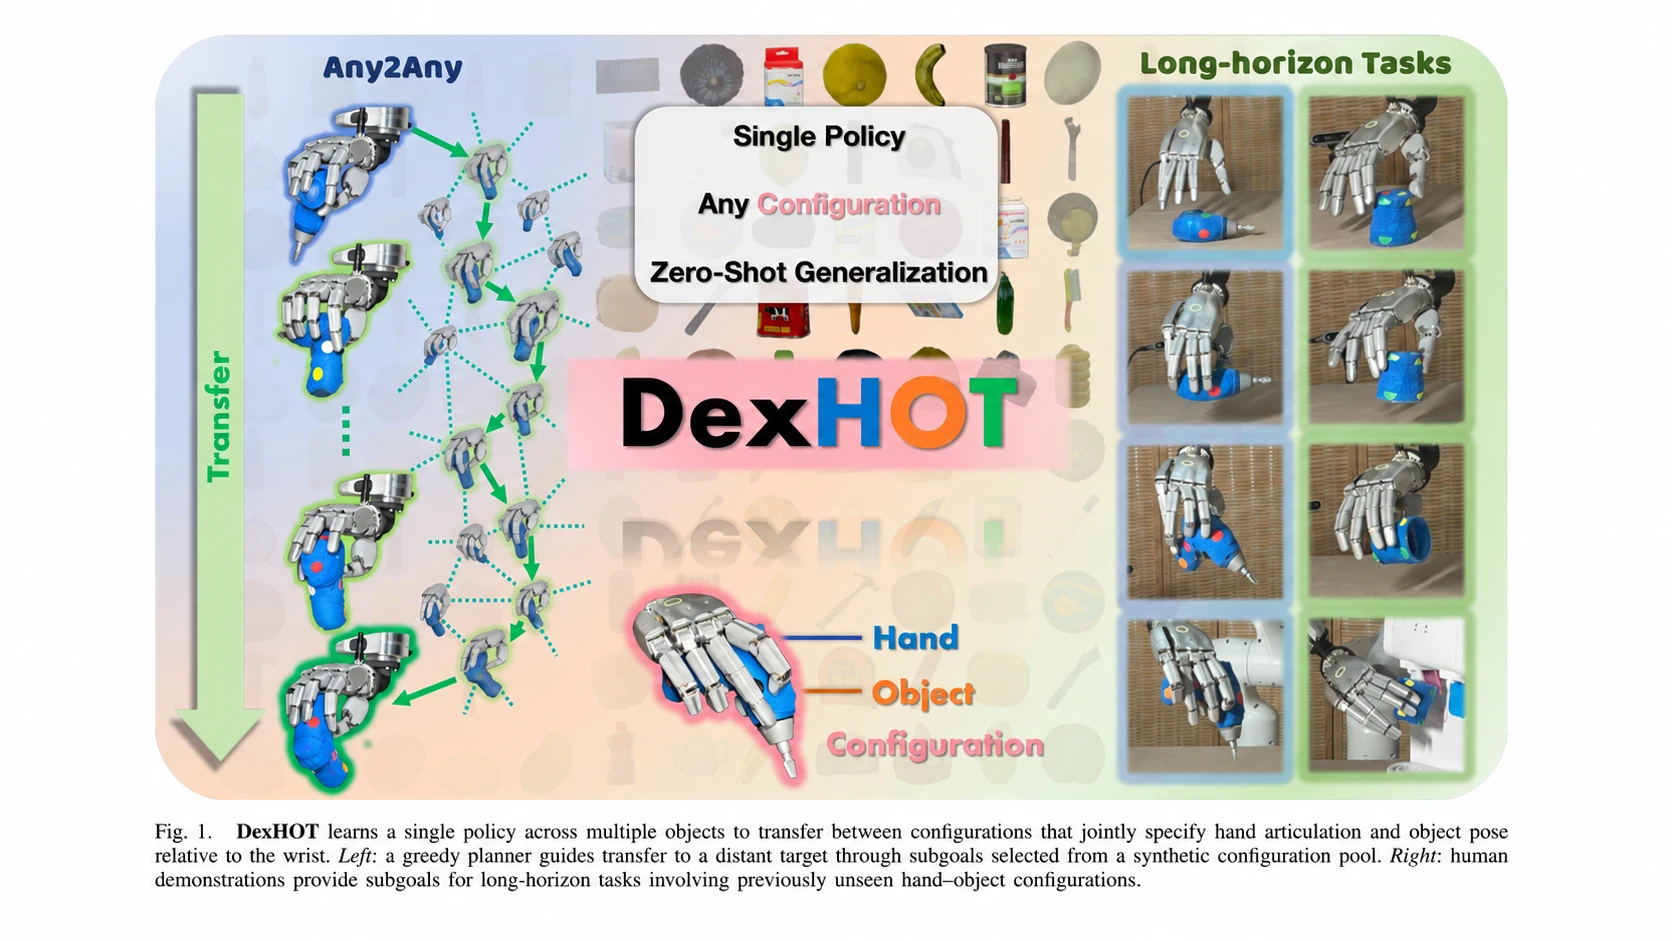
30 次真机任务测试 27 次达标,北大董豪团队让灵巧手换个握法
灵巧操作最棘手的难点,在于手该以何种姿态与物体接触。同一个杯子,抓杯沿、握把手、托杯身,即便物体最终位姿完全一致,操作稳定性、能否衔接后续动作也天差地别。 针对这个问题,11 月 3 日,北京大学计算机学院前沿计算研究中心、多媒体信息处理全…
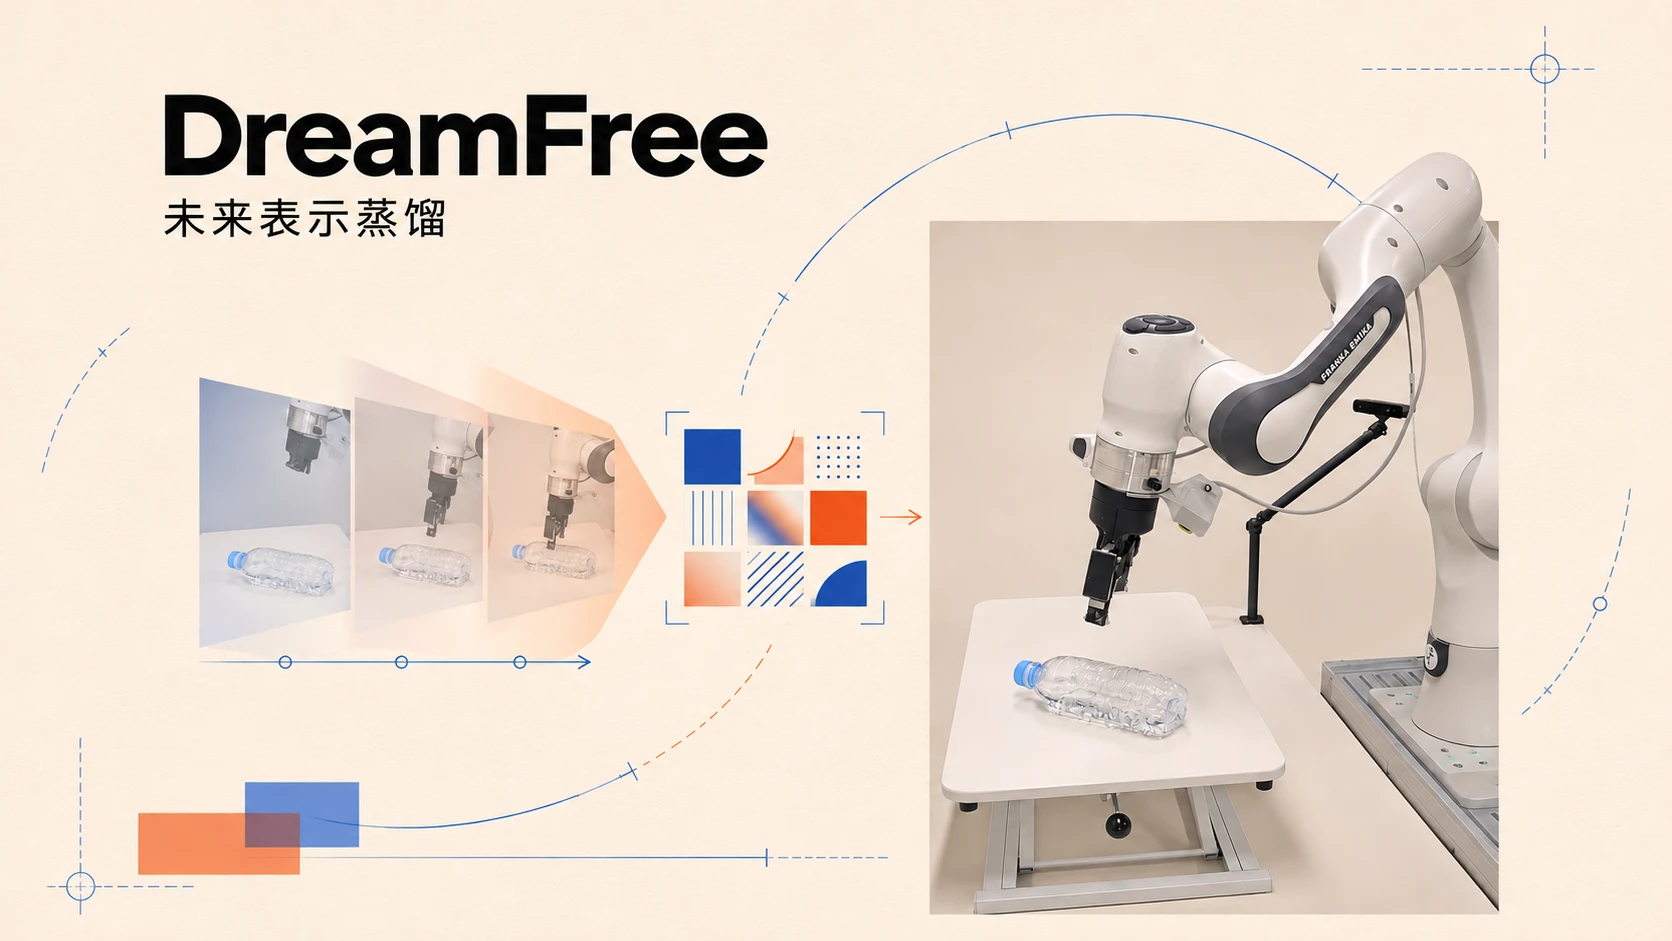
DreamFree 依托表征蒸馏,脱离未来视频生成实现机器人控制
机器人想要学会操作,首先要预判场景接下来会如何变化。不少世界动作模型会借助预训练视频扩散模型完成这件事:先脑补出未来画面,再依据画面输出动作。但生成想象画面是部署阶段成本最高的环节,生成一组动作序列需要执行数十步去噪。一旦想象的画面出现偏差…
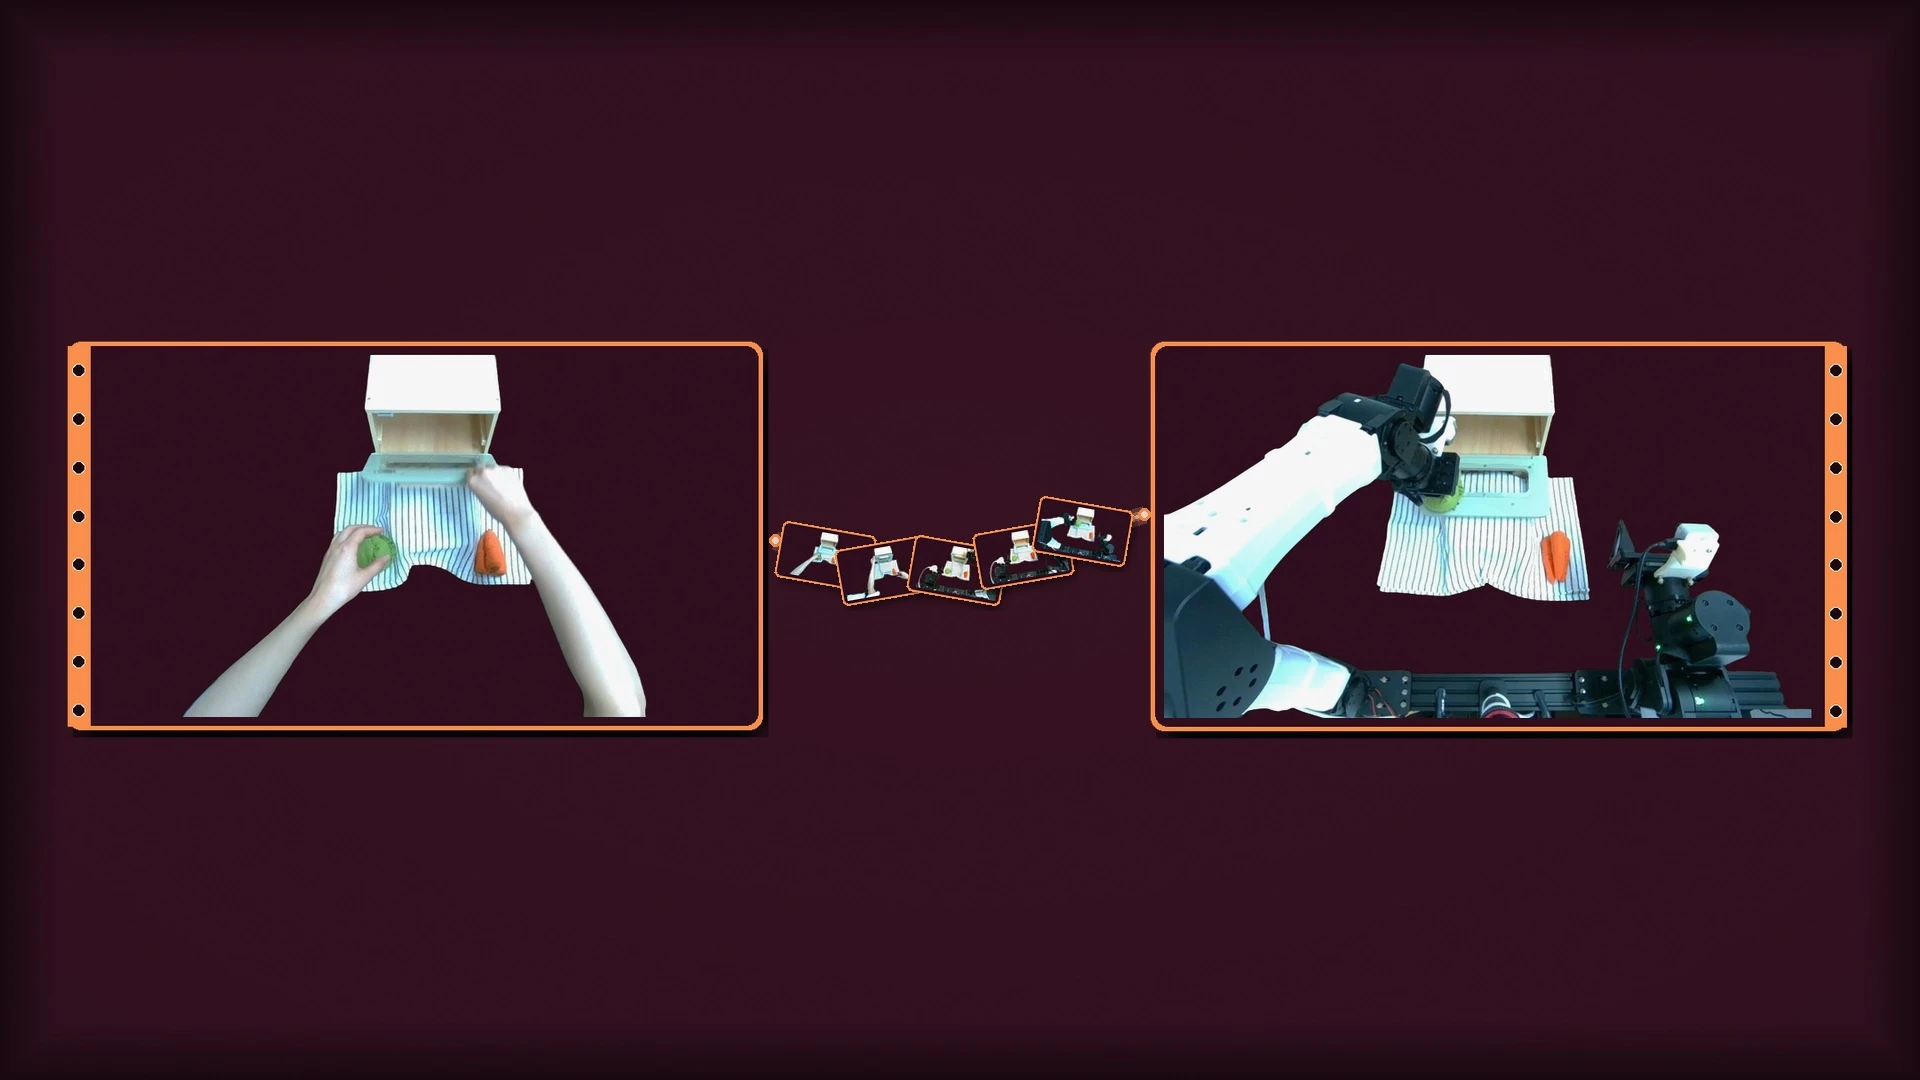
英伟达提出 ThinkWorld,把动作写成链,用想象的未来判对错
机器人演示采集成本高,覆盖的场景和动作有限。互联网上虽然有大量人类第一视角视频,却零散杂乱,也没有机器人可以直接执行的动作标签。VLA 怎样吸收这些视频里的操作经验? 针对这个问题,英伟达联合 KAIST(韩国科学技术院),于 10 月 2…
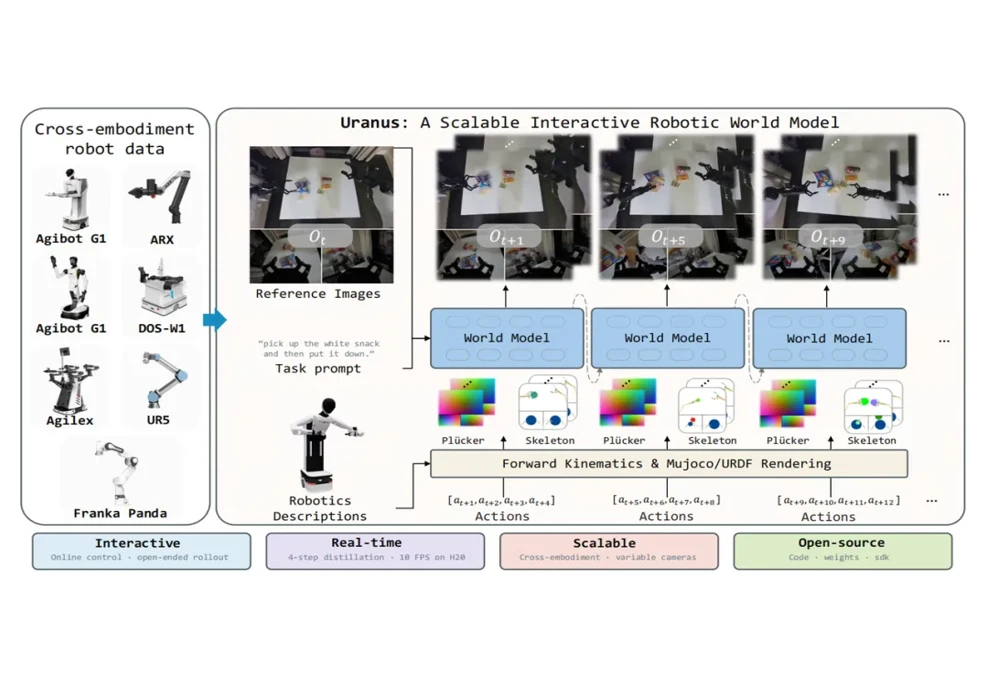
地瓜机器人开源 Uranus 世界模型仿真平台,RoboTwin 闭环评测相关性达 0.98
10 月 27 日,地瓜机器人大模型团队开源 Uranus 技术报告,并同步开放推理代码、SDK 和模型权重,面向全球开发者与研究者开放 100 个早期体验名额。Uranus 面向机器人策略的交互测试与比较:真机实验受设备、周期和安全条件限…
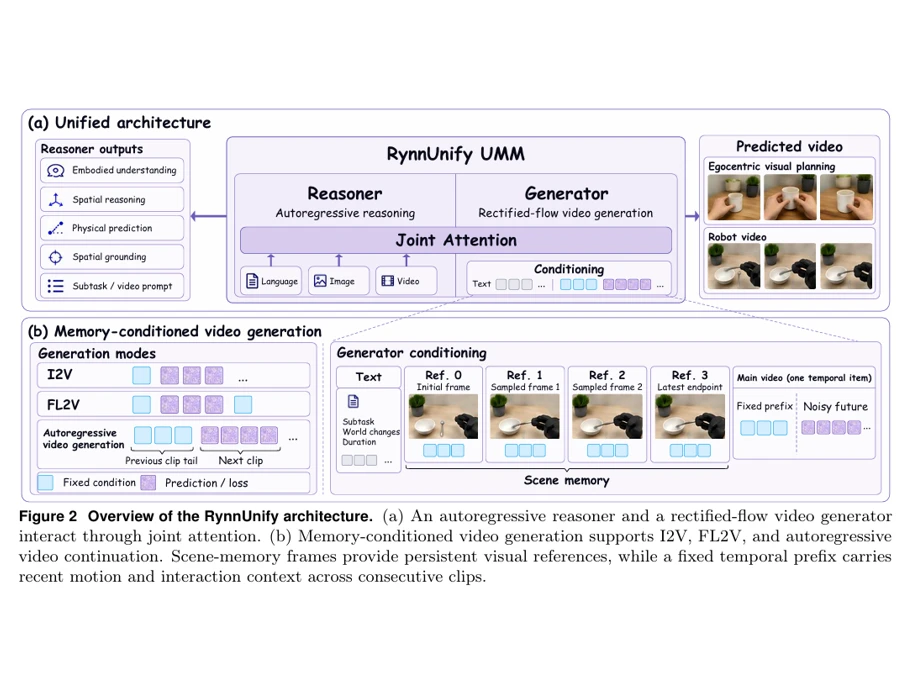
8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑?
主:8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑? 副:大模型,开始用视频打草稿 小红书正文 对于机器人来说,脑补被遮挡的物体实在太难了。10 月 23 日,阿里巴巴达摩院团队联合湖畔实验室发表论文《迈向统一具身大脑》(…
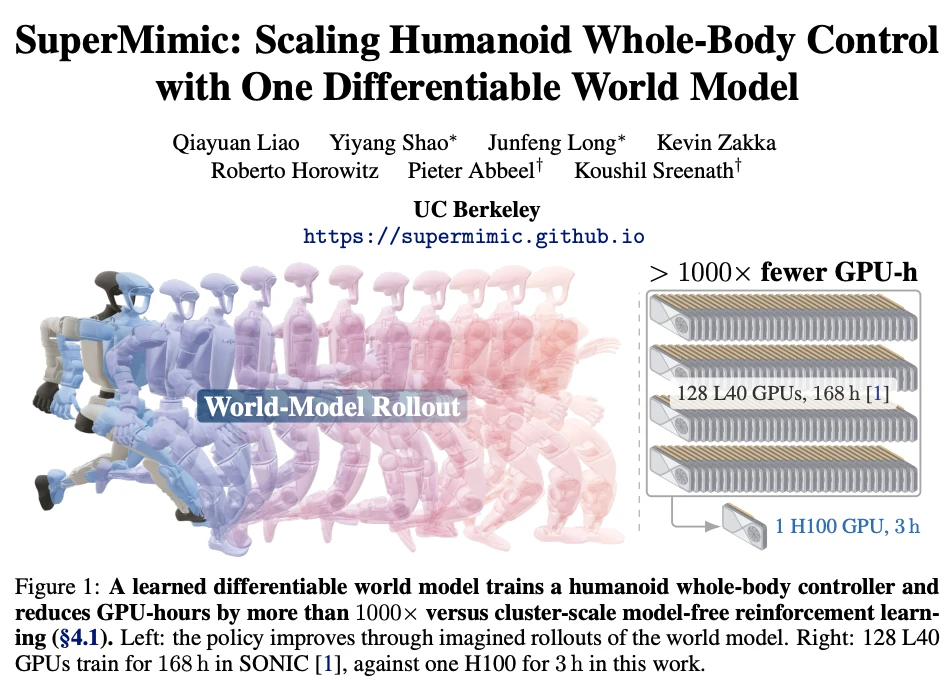
UC Berkeley 团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线
UC Berkeley 团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线 人形机器人想要掌握行走、跳跃乃至空翻,背后需要多大的训练算力? 过去的常规做法,是让机器人在模拟器内不断试错,依靠强化学习优化动作控制策略。动作…
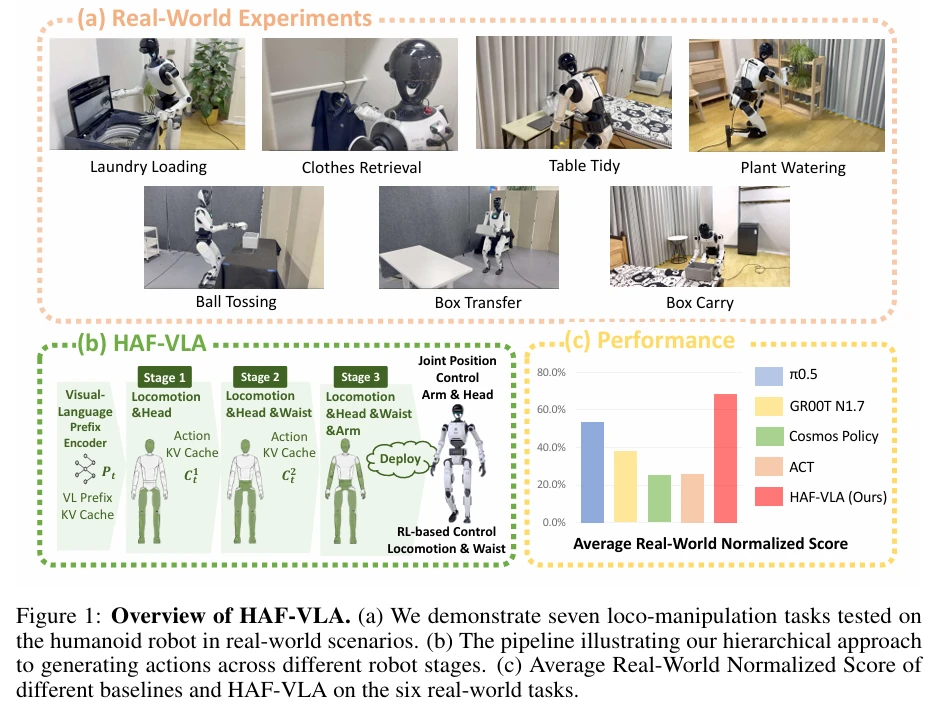
仉尚航等提出 HAF-VLA,让人形机器人分层生成协调的全身动作
仉尚航等提出 HAF VLA,让人形机器人分层生成协调的全身动作 人形机器人要学会自主走向目标、俯身、再伸手抓取,卡点在于全身动作的协同生成。腿、腰、头部与双臂串联在同一条运动学链上:底盘偏移几厘米、腰部角度差几度,手臂就得伸得更远代偿。持…
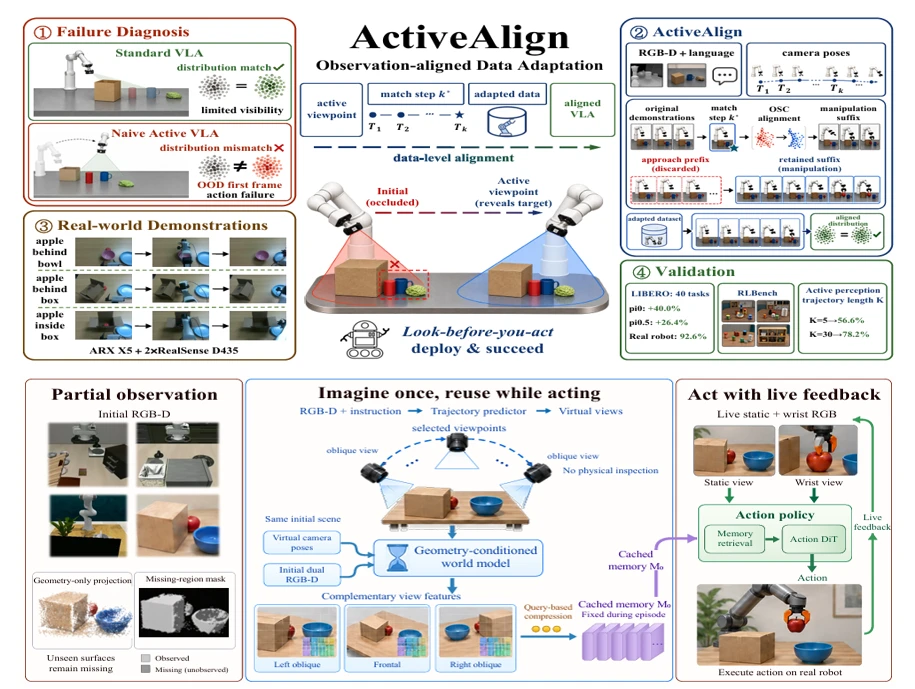
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作 机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关…
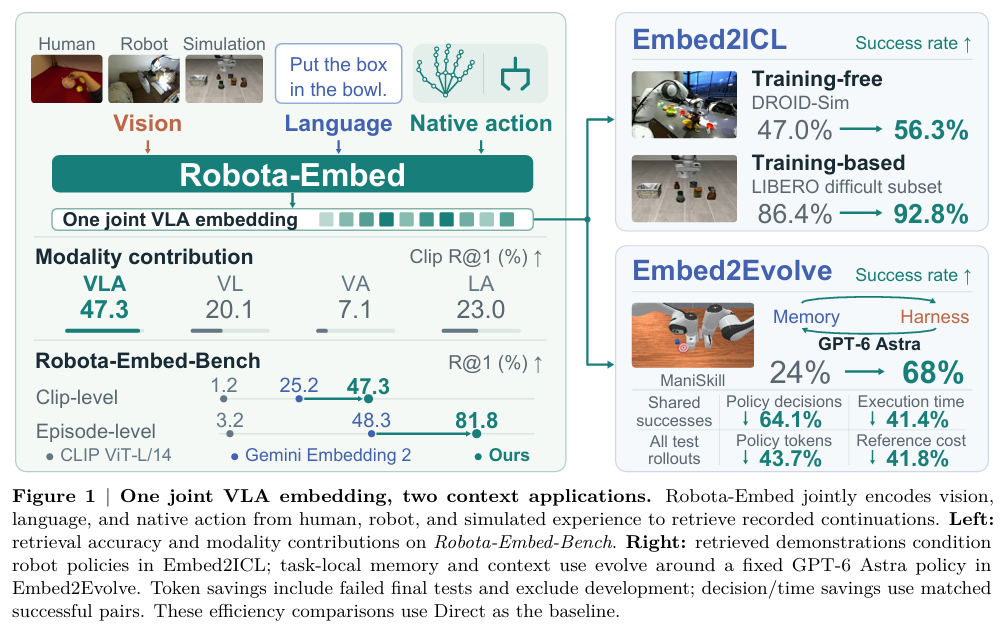
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
「摔倒」方显真差距,I-BFM 把物理交互训进行为基座模型
这两年有不少惊艳的机器人搬箱子的 demo,但不知道大家是否有注意到一个细节,绝大多数 demo 里,一切都是按剧本走的。箱子摆在它该在的位置,机器人站得笔直,一遍过,没有任何干扰,甚至大部分镜头里都没有人的出现。 现实世界不是这样。手会没…
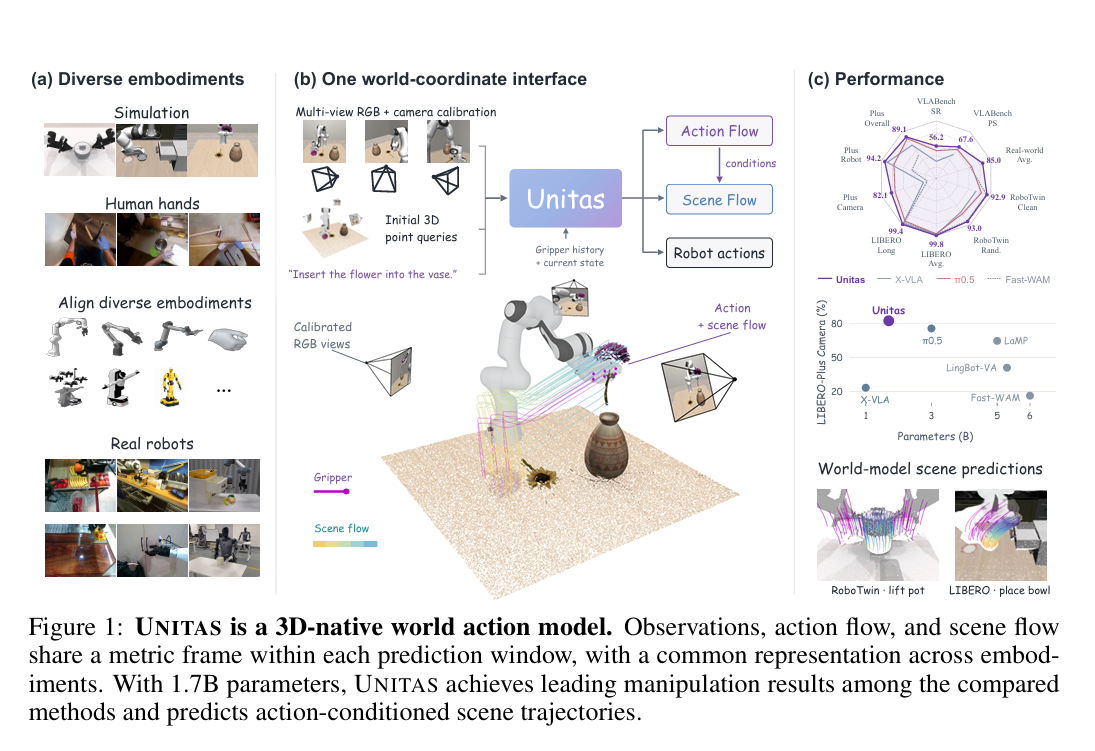
贾奎团队新作:让世界动作模型真正理解三维空间
UNITAS 将观测、动作与场景变化统一至同一个米制三维坐标系:以点轨迹表征人手与夹爪的运动,用场景流描述场景点的位移,让世界动作模型不再单纯依靠图像推测环境演化。模型参数量仅 1.7 B,在 LIBERO 基准测试上取得 99.8 % 任…

对话 StageCraft 作者,聊一聊 VLA 从本体迁移到环境变化差在哪
今年 IEEE/RSJ 智能机器人与系统国际会议(IROS)于 9 月 27 日至 10 月 1 日期间在美国匹兹堡召开。 本届 IROS 收录的论文接近 1,900 篇,分设三百多个主题报告场次。 作为机器人领域与 ICRA 齐名的两大顶…