

DreamFree 依托表征蒸馏,脱离未来视频生成实现机器人控制
作者:江思奇
机器人想要学会操作,首先要预判场景接下来会如何变化。不少世界动作模型会借助预训练视频扩散模型完成这件事:先脑补出未来画面,再依据画面输出动作。但生成想象画面是部署阶段成本最高的环节,生成一组动作序列需要执行数十步去噪。一旦想象的画面出现偏差,输出的动作也会随之出错。
视频扩散模型已经从海量视频数据中,学到物体下落、布料褶皱、开关门窗这类时空规律,这些信息对机器人控制十分有价值。难点在于,如何提取这些规律,同时不必生成完整的未来视频片段。
11 月 3 日,KAIST 团队发表论文《Future Representation Distillation for Imagination-Free World Action Models》(《面向无想象世界动作模型的未来表示蒸馏》),提出 DreamFree,一种把视频扩散模型的预测能力压进视觉编码器的世界动作模型,让机器人只看当前一帧就能出动作。
论文共 8 位作者,Jaehyeong Jo 与 Sangwon Jang 为共同第一作者,KAIST 教授 Sung Ju Hwang 与助理教授 Kimin Lee 担任共同指导。
DreamFree 的训练流程分为两个阶段。
- 第一阶段只利用视频数据训练:冻结视频扩散模型,让它同时观察当前帧与未来帧;而仅接收当前帧输入的编码器,负责对齐教师模型输出的中间表征。
- 第二阶段固定编码器参数,依托动作示范数据,训练特征读取模块与动作解码器。
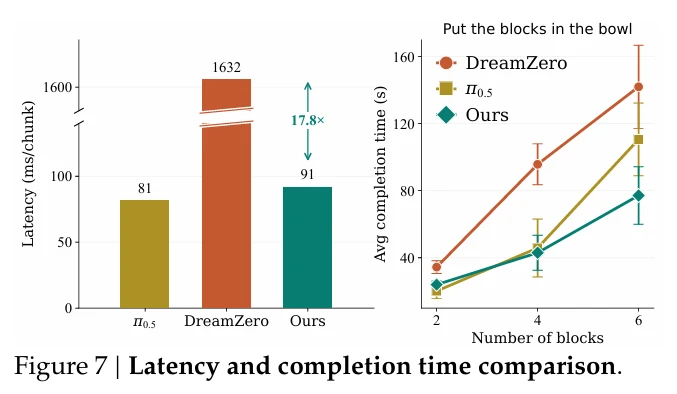
基于 14B 底座的模型,在 DROID 的十个真机任务上平均成功率为 64%;作为对照,DreamZero 为 56%,π0.5 为 16%。单次动作块推理耗时 91 毫秒,控制频率可达 11 赫兹,相比 DreamZero 提速 17.8 倍。在 RoboCasa 的二十四个任务上,平均成功率 71.7%;额外加入无动作标签的视频数据后,指标提升至 74.4%。
这项工作最核心的巧思,在于监督信号的落点。团队借助结构化掩码,隔离当前帧与未来信息,蒸馏过程直接作用于动作模块读取的特征层,让学到的预测能力真正融入控制链路。动作预测并不一定需要完整视频的像素细节,只需要提取可供动作模块读取的有效信息。
这套路线后续的上限,取决于蒸馏得到的表征是否可靠承载未来信息,以及这一层特征能否借助更大规模的视频底座、更多视频数据,持续提升机器人的控制性能。
把未来表征蒸馏进当前帧特征
DreamFree 的实现链路分为四步:先改造视频扩散骨干,得到仅接收当前帧输入的编码器;再借助结构化掩码,杜绝编码器直接读取未来信息;随后从冻结的教师模型中蒸馏出未来表征;最后由模型将这组表征解码输出动作。
**第一步,改造编码器。**团队在预训练视频扩散骨干的基础上初始化模型,取当前帧 latent token 的隐藏状态作为视觉表征。原版骨干采用双向注意力机制,当前帧可以看到未来帧,蒸馏得到的特征就无法区分信息是观测得来,还是预测得来。
**第二步,依靠掩码阻断这条通路。**当前帧的 token 仅能互相做注意力交互,未来帧的 token 可以读取当前帧与自身,同时关闭未来 token 上的文本交叉注意力。处理之后,当前帧的隐藏状态只由当下观测和任务指令决定。掩码把当前帧限制在当下,编码器想要获取未来信息,只剩下蒸馏这一条途径。
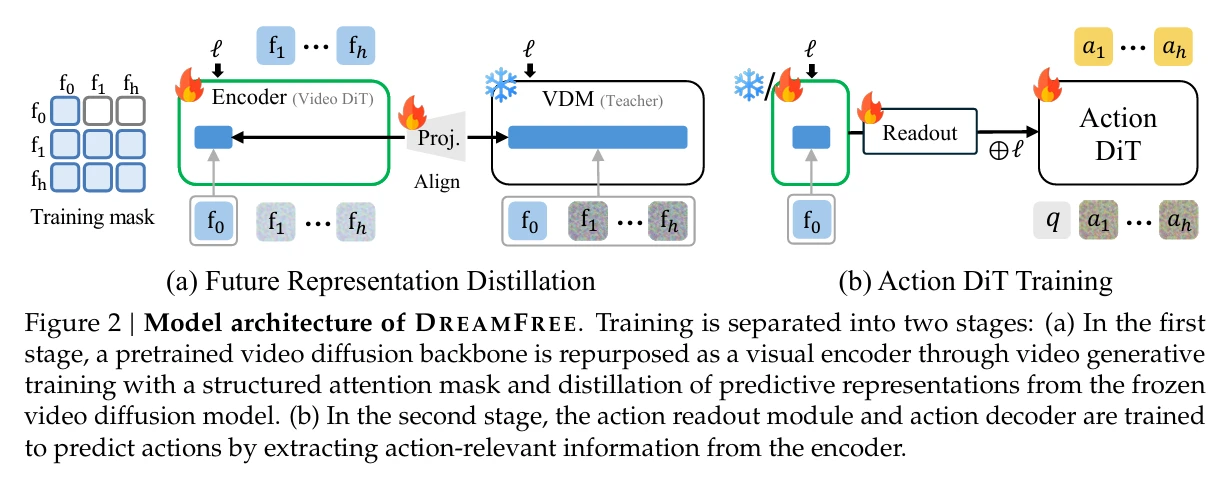
整套流程的核心在于监督落点。施加掩码约束后,当前帧特征只能自主推断未来;而蒸馏对齐直接作用于这一层特征,恰好就是后续动作模块读取的输入。
**第三步,执行表征蒸馏。**教师模型复用这套视频扩散模型,全程冻结权重。教师输入完整视频片段与指令,从加噪 latent 中抽取第 j 层表征,这一层表征同时见过当前帧和未来帧。学生模型仅输入单张干净的当前帧图像,经由投影器把 N 个 token 扩展为 F×N 个,补充帧嵌入之后,再通过两层解码器对齐教师模型的时空排布。
扩展至 F×N 个 token,目的是让单张当前帧,也能够和教师的整段未来序列逐位置做比对;损失函数只计算未来位置上的余弦相似度,两边都剔除当前帧 token,避免模型学会直接复制输入的捷径。团队同时保留骨干原生的流匹配生成损失,防止编码器遗忘预训练阶段学到的视频生成规律,两项损失一同反向传播更新参数。
**第四步,从特征读出动作。**读出模块提取编码器第 k 层的特征,利用 64 个可学习 query,经过两层自注意力与交叉注意力,把视觉 token 压缩成定长的动作 token,让动作解码器不用适配变化数量的视频 token。动作解码器为参数量 1B 的 DiT,包含 30 个 block,隐层宽度 1024,注意力头 24 个,在动作空间内用流匹配完成去噪;条件输入包含动作 token、任务指令、机器人本体状态,在 DROID 任务上额外增加 8 步动作历史。部署阶段编码器只推理一次,解码器迭代 10 至 16 步,生成动作块之后,按照数据集设定执行前 10 步、24 步或是 32 步。
网络结构确定之后,决定方案能否跑通的关键,是训练次序:编码器优先学习表征蒸馏,动作模块放在后续训练。
分段训练与低延迟部署优化
完整训练流程分为三段:先对视频骨干做机器人画面适配,再依托无动作标签的视频数据训练编码器,最后利用动作示范数据训练读出模块与动作解码器。部署阶段仅保留编码器单次前向推理。
**第一阶段为骨干适配。**团队选用 Wan2.2-5B 与 Wan2.2-A14B 的高噪专家模型,连同文本编码器、视频 VAE 一同微调,输入按照自研打包格式处理的多视角画面。适配完成后的权重,同时初始化教师模型与学生模型;教师模型后续全程冻结,学生模型则带上结构化掩码继续训练。
**第二阶段仅使用视频数据,不引入动作标签。**视频片段经过 4 倍时间下采样得到 9 帧,当前帧保持原始干净状态,未来帧在随机时间步添加噪声。教师侧另行设定固定噪声等级,仿真基准任务取 0.7,DROID 任务取 0.8,从加噪视频中抽取表征作为蒸馏目标。
学生与教师选取的特征层随底座规格固定:5B 版本蒸馏取第 25 层、读取特征取第 19 层;14B 版本蒸馏、读取两处都取用第 31 层。仿真实验采用 rank-128 LoRA 微调编码器,DROID 上的 14B 模型则直接全量微调;优化器统一使用 AdamW,学习率设置为 1e-4。
**第三阶段才接入动作标签。**编码器参数冻结,读出模块与动作解码器从零开始训练,输入包含当前观测、任务指令、本体状态以及动作块,损失函数采用动作空间内的流匹配损失。动作块固定长度为 32,DROID 任务额外附带 8 步动作历史;训练过程中,整段历史序列有 0.2 的概率被丢弃,缺失位置依靠掩码填充。不同数据集设置独立批大小,DROID 两个训练阶段的批大小分别为 64 和 4096,整套训练在 16 张 H200 显卡上运行,耗时约一周。
将编码器和动作模块拆分训练,是这项工作另一处关键设计。编码器仅由视频信号监督塑造,训练结束后就固定参数,再单独训练动作模块,避免动作梯度反向改动已经学好的视觉特征。团队在附录中将这种隔离思路和 Knowledge Insulation 类比,差异在于本工作把这套范式迁移到了视频扩散模型之上。
部署阶段的计算开销集中在编码器的单次前向推理。流程不再包含视频去噪,也无需无分类器引导;动作侧仅执行 10 步或 16 步欧拉积分。
工程优化也围绕这一环节展开:指令嵌入会在多次查询之间缓存,动作条件对应的 key 与 value 在同一个动作块内只计算一次,块内所有去噪步骤都可以复用。
团队借助融合注意力核、融合 QKV 投影、torch.compile 以及 CUDA graphs,将 VAE 编码、特征提取、动作采样串联成完整重放链路。
基于 14B 底座的模型,在单张 H200 显卡上,单个动作块推理耗时 91 毫秒,控制频率可达 11 赫兹,显存占用可以适配单张 48GB 的 A6000。这套方案把部署开销从视频去噪转移到动作去噪:前者往往需要几十步迭代,后者仅需 10 至 16 步。
速度指标已经达标,但这层蒸馏得到的特征究竟学到了哪些未来信息,仍需要实验来佐证。
仿真登顶,真机验证控制性能
验证工作分为四层递进:首先检验特征是否承载未来信息,再测试仿真环境下的表现,接着开展真机实验,最后测算推理延迟与吞吐。逐层提供佐证,从表征层面一路验证到机器人实体控制。
**第一组实验采用探针测试。**团队基于冻结后的特征训练两类探针:动作探针用于预测动作序列,未来探针负责重建未来帧的 VAE 潜变量。对比一共设置四组:仅输入当前帧的原生视频模型、移除蒸馏分支的编码器、DreamFree 编码器,以及可以直接读取真实未来帧的视频教师模型。
在动作探针测试中,DreamFree 编码器的预测误差,低于仅看当前帧的视频模型和去掉蒸馏的对照组,也优于当前帧叠加未来帧 VAE 潜变量的方案,性能接近能够直接观测未来帧的教师模型。在未来探针任务上,它在 RoboCasa 数据集上和看过未来帧的教师模型表现贴近,在 DROID 数据集上仍存在小幅差距。读出模块输出的特征再送入动作探针,误差还能进一步降低。仅依靠当前帧提取的特征,就可以重建出接近观测过未来画面水平的未来帧潜变量。
这套探针设计的巧妙之处,是将两个核心问题拆解开验证。未来探针重建未来帧 VAE 潜变量,用来回答特征里是否包含未来信息;动作探针预测动作,用来验证这些未来信息能否被控制模块有效读取。两项测试相互独立,且所有对照组复用同一套探针,性能差异就可以归因于表征本身的质量。
**第二部分为仿真评测。**DreamFree 在 LIBERO 的四个套件上平均成功率 98.6%,和同期最优的 LingBot-VA 的 98.5% 基本持平。在 RoboCasa 的二十四个厨房任务中,14B 底座平均成功率 71.7%,高于 Cosmos Policy 的 67.1% 以及其他 VLA 基线;同样在部署阶段跳过视频生成的 Fast-WAM,仅为 44.4%。底座规模从 5B 升级到 14B 时,DreamFree 指标提升 13.2 个百分点,而 Fast-WAM 只提升 0.3 个百分点。这说明生成监督本身不等于可用于控制的预测表征,蒸馏才是让更大底座转化为更高任务成功率的关键环节。
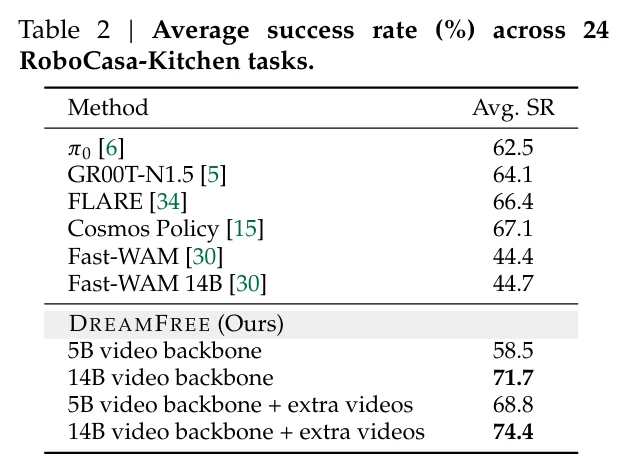
消融实验分别移除两项损失,更能看出蒸馏的权重。去掉蒸馏损失后,RoboCasa 上的成功率从 71.7% 下跌至 47.2%,降幅明显大于移除生成损失的情况;额外引入无标签视频数据,可以把 14B 版本的指标从 71.7% 提升至 74.4%。
**第三部分是真机测试。**DROID 的十个任务,每组重复五次,全程零样本部署,不针对任务做微调。DreamFree 平均成功率 64%,任务完成进度 83%;DreamZero 对应为 56%、71.8%,π0.5 为 16%、33.5%。
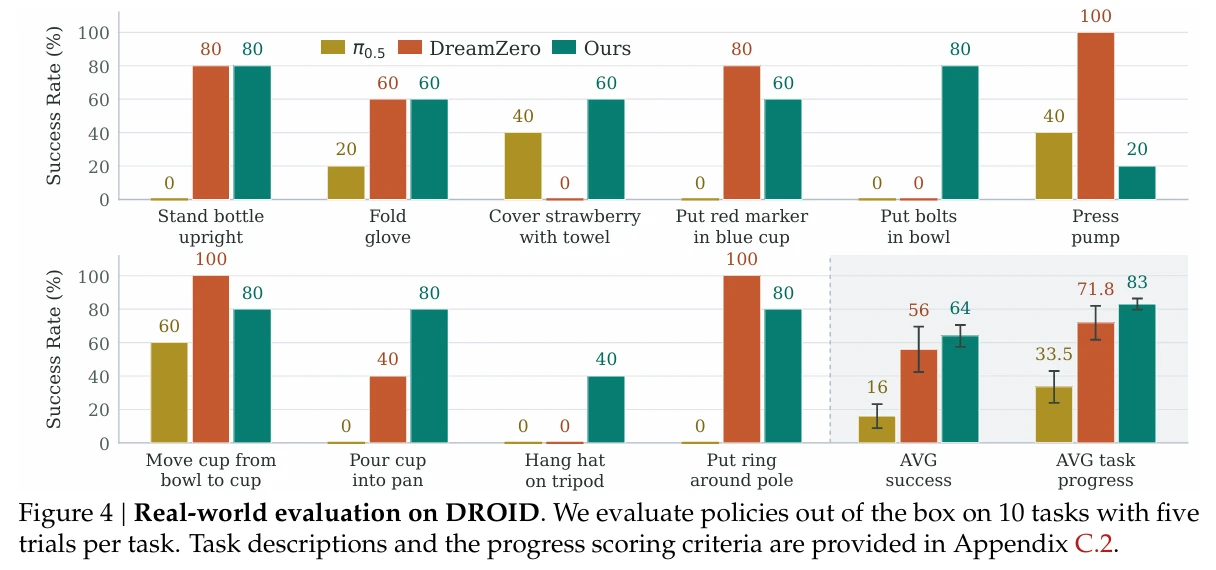
性能差距集中在需要处理物体形变、连续物品重排的任务上。盖草莓、将帽子挂到三脚架、把三颗螺栓放入碗中这三项任务,DreamZero 五次尝试全部失败,DreamFree 却存在成功轮次。从失败回放可以观察到,DreamZero 一旦首次动作出现偏移,往往会顺着错误轨迹持续执行;DreamFree 则具备修正能力,可以重新对准目标。
团队还在 YAM 双臂机器人平台补充了一组实验。训练只用 ABC-130k 里约 100 小时的子集,只占到全部三千五百小时数据的约三十五分之一。在全新场景、全新物体上,模型依然可以完成装盘、打开笔帽、折叠布料这类操纵动作。
**第四项实验测算推理延迟。**DreamFree 单个动作块耗时 91 毫秒,DreamZero 为 1632 毫秒,π0.5 为 81 毫秒。和 π0.5 相比,DreamFree 仅增加一成左右的延迟,就换取了四倍的平均成功率。在把不同数量积木放入碗中的对比里,两块、四块积木场景下三者的完成时长接近;六块积木场景中,DreamFree 速度优势显著。不需要等待视频生成再输出动作,闭环中省下的时间直接转化为更高的吞吐。
真机实验得到验证之后,还有一个待解问题:面对全新任务,模型能否只依靠视频数据完成泛化。
仅凭视频,拓展全新任务
视频迁移设计了三种接入方式:在编码器预训练阶段加入同本体视频、加入其他本体的视频,或是策略训练完成后仅微调编码器。这三种方式都不提供新任务对应的动作标签。
**第一种是原子技能组合成复合任务。**复合任务由多项原子技能串联构成。团队在 RoboCasa 中选取三项复合任务,将对应视频加入编码器的预训练流程,动作模块依旧只使用原子任务的示范数据训练。
基线模型在这三项任务上完全无法完成,平均成功率为 0%。引入视频并搭配蒸馏之后,平均成功率提升至 21.7%,三项任务各自都出现成功回合;同样加入视频、但移除蒸馏分支时,平均成功率依旧停留在 0%。以微波炉解冻为例,任务需要依次完成开门、放入物品、关门、按下开关,四个子目标全部按顺序达成才算成功,DreamFree 可以走完这一整套动作流程。
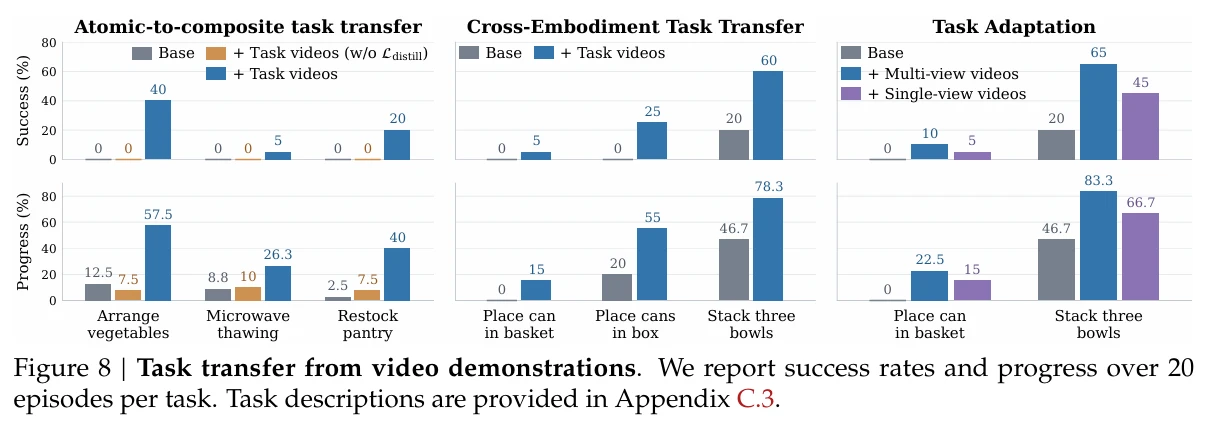
**第二种是跨本体迁移。**目标机器人选用 RoboTwin 中的 ALOHA-AgileX,补充的迁移视频由双臂 Franka Panda 采集,每项任务 50 条,合计 150 条。基线模型仅能在叠碗任务上偶尔成功,三项任务平均成功率 6.7%;引入跨本体视频之后,平均成功率提升至 30%。全程动作标签只来源于 ALOHA-AgileX 的原子任务,新任务没有提供任何动作示范。
**第三种是训练后增补视频。**团队基于 RoboTwin 原子任务的模型,先将目标任务从训练集中剔除,后续只微调编码器,动作模块全程冻结。每项任务提供 10 条视频,在单张 H200 上微调耗时约 10 分钟。
三种迁移方案共用一套约束:新任务的视频只输入编码器,动作模块始终依靠原子任务的动作标签完成训练。任务相关的时序知识收敛在表征层,已习得的动作技能保留在动作模块内。依靠这个隔离设计,团队可以区分视频带来的增益,来自任务时序逻辑,还是全新的动作原语。
多视角视频带来的指标提升明显高于单视角视频,说明编码器能够从画面中补齐任务相关的状态演变信息。对于开柜子这类需要全新动作技能的任务,只微调编码器无法学会;这套方式能掌握的,大多是已有原子技能的全新组合。视频补充进来的是任务的执行顺序,想要掌握从未见过的动作,依旧依赖动作示范。
DreamFree 将预训练视频扩散模型改造为具备预测能力的视觉编码器,借助未来表征蒸馏,让单帧图像的特征承载未来场景信息。部署阶段不再生成未来视频,动作直接从这层特征解码输出,仿真与真机实验同时验证了控制性能,推理延迟也得到大幅降低。
团队的核心结论落脚于预测性表征学习:这是一条把预训练视频里的时空知识转化为机器人控制能力的可行路线。更大规模的视频底座、更多视频数据可以持续提升控制表现;同时,无动作标签的视频示范,也能够用来拓展模型可完成的新任务。