

相机
共 47 篇相关内容
触觉正在成为机器人训练的下一种数据丨IROS 2026 现场
9 月 27 日,2 026 IEEE/RSJ 智能机器人与系统国际会议 IROS 在美国匹兹堡开幕,42号电波来到了现场。 好几场分会场全程座无虚席,室内席位早早被占满,会场大门一直敞开,门外还围着不少站立旁听的人。IROS 覆盖的议题很…
对话 IROS 最佳论文奖入围团队,揭开机器人「晕玻璃」的秘密
9 月 27 日至 10 月 1 日,第 39 届 IEEE/RSJ 智能机器人与系统国际会议(IROS 2026)在美国宾夕法尼亚州匹兹堡 大卫·劳伦斯会议中心( David L. Lawrence Convention Center)举…

对话日冕钟元鑫:工业场景更适合验证 Physical RSI
最近,RSI 正重新成为 AI 行业的高频词,而在具身智能领域,它已经开始被推向一个更具体的问题:机器能不能在真实世界里自我改进? RSI,即 Recursive Self Improvement,指系统能够参与改进自身的代码、工具或训练流…
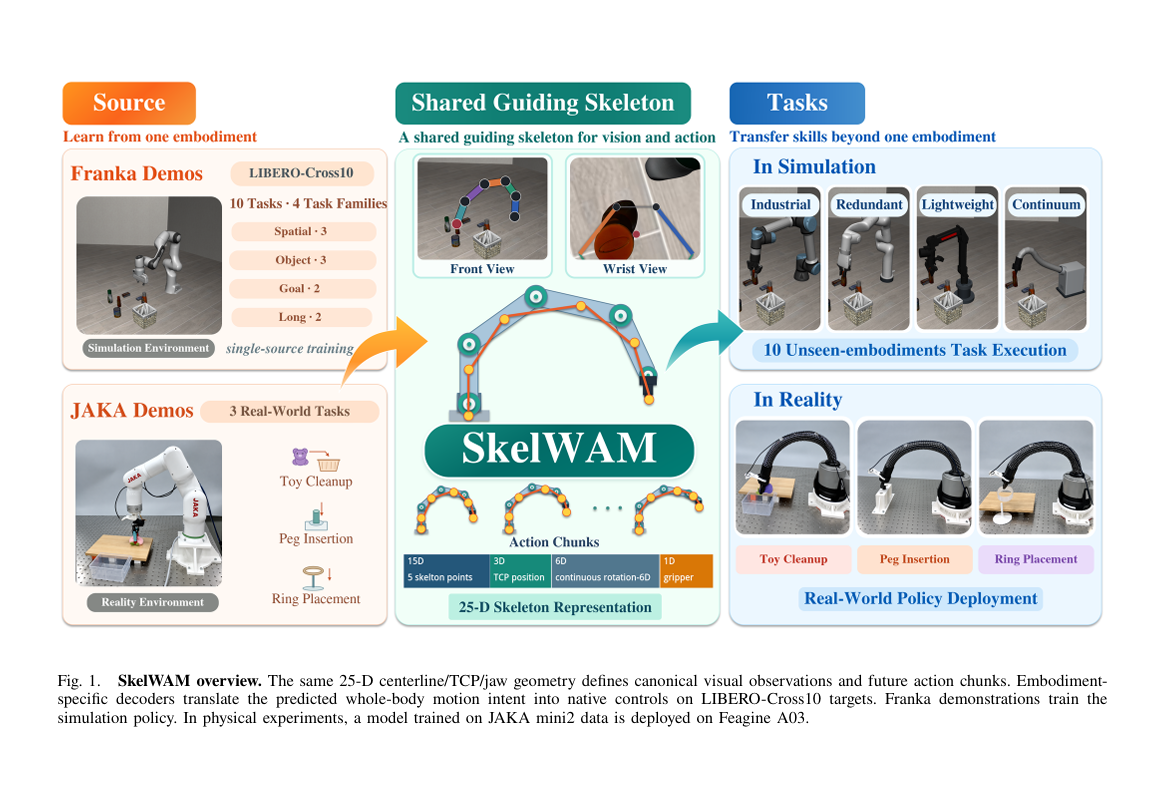
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移…
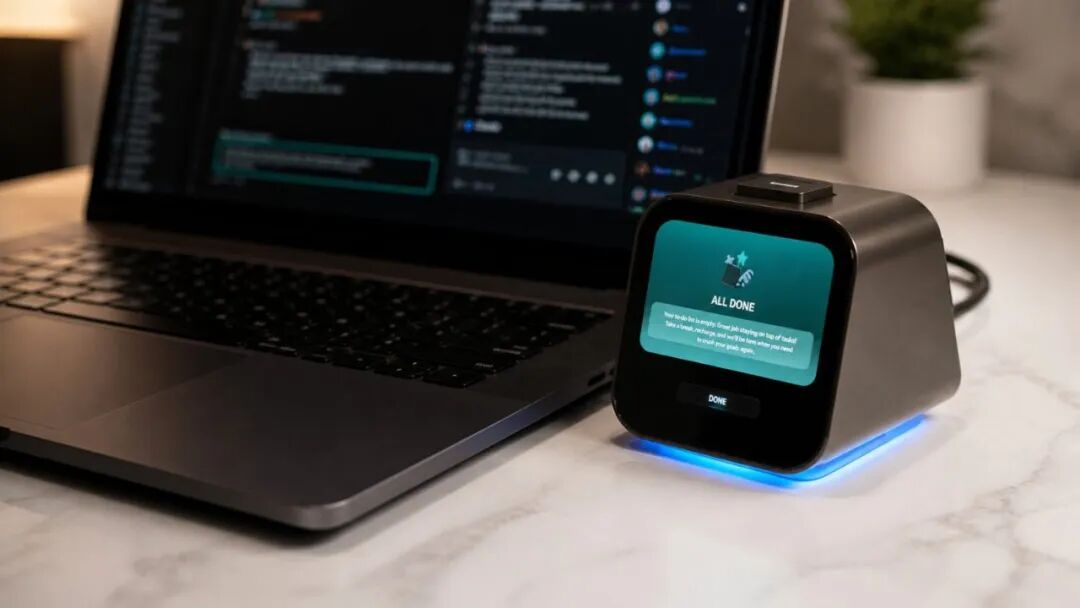
众筹 20 小时破百万美元,让 AI 接手电脑操作有人买单
让 Agent 帮忙处理工作,往往还需要人做不少准备:复制资料、上传文件、解释页面上的内容,再把生成结果搬回原来的软件。如果 AI 能直接看懂电脑屏幕,接着操作鼠标和键盘,像身外化身一样帮你处理工作,能提升多少工作效率? 「深圳本惟无界科技…
苹果 AI 路线清晰了,但离闭环还差很远
特努斯(John Ternus)接手 CEO 后的第一场发布会,开场没讲产品,先讨论了一个问题:一台真正为 AI 准备的设备,应该长什么样? 他列的条件是:能理解个人上下文,一直跟在身上,有能本地跑模型的处理器,也有联网调用云端模型的能力,…
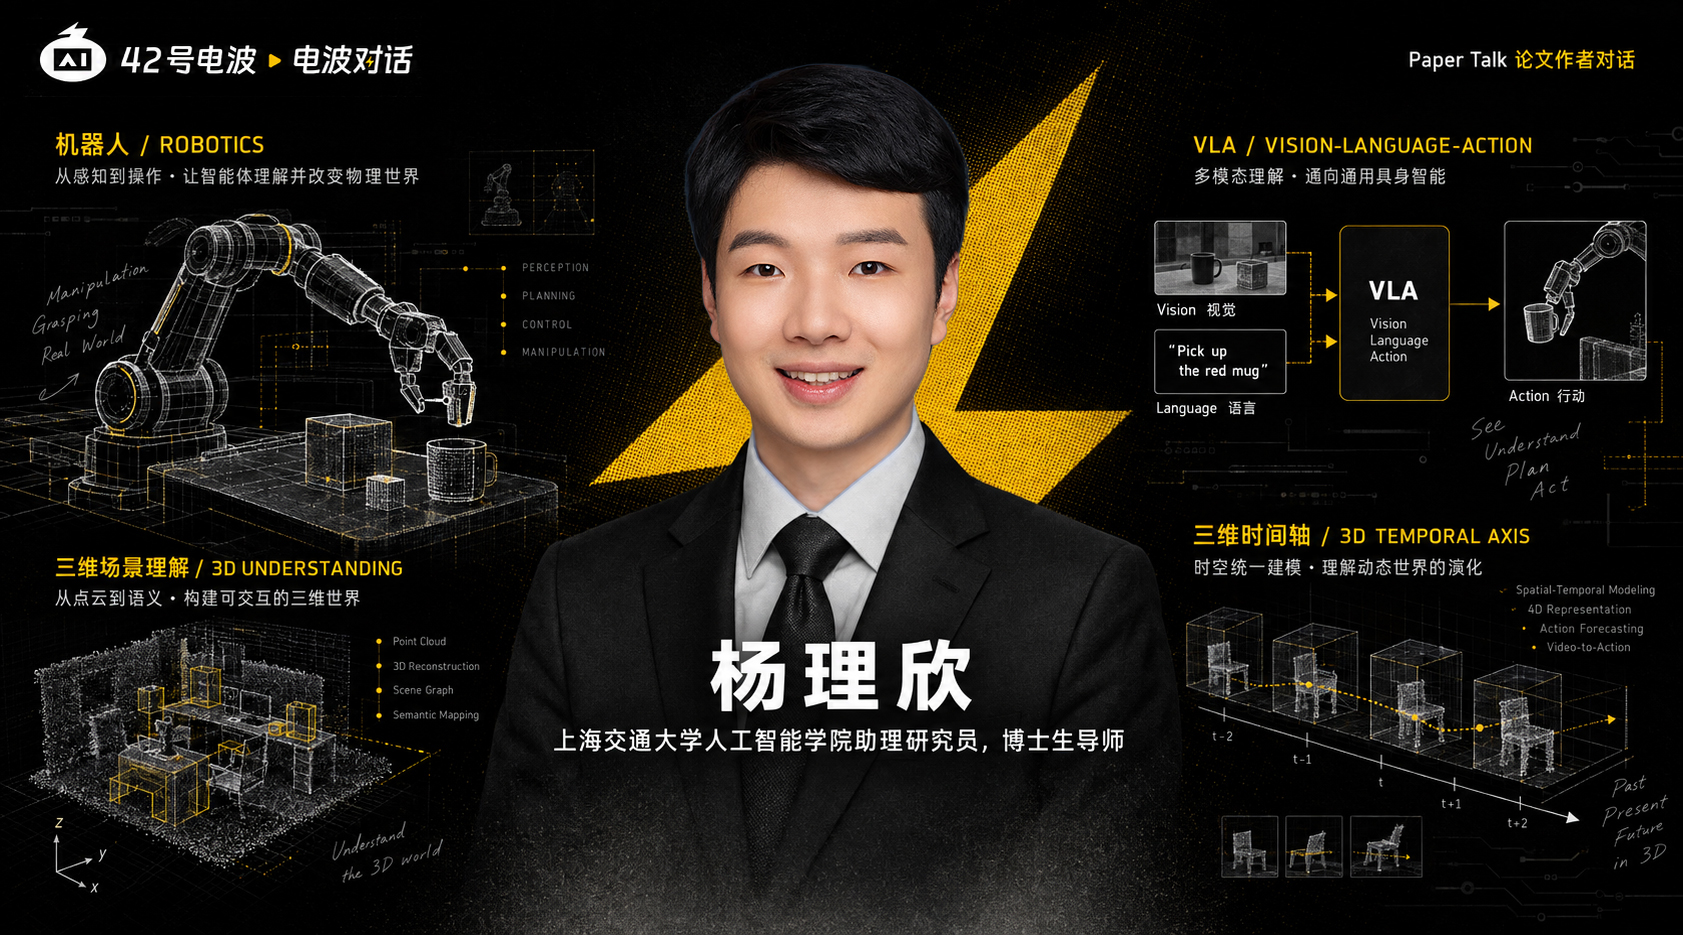
对话上海交大杨理欣:为什么机器人需要一条「三维时间轴」
机器人会倒水,却可能在放下瓶子后忘了刚才倒过哪一瓶。会执行动作,不等于知道任务该如何推进;机器人还需要把任务意图、行动历史与世界变化连成一条三维时间线。 这类失败不完全是抓取精度问题。今天的视觉—语言—动作模型(Vision Languag…
独家探访停摆机器人数采场,具身智能正在重算数据这笔账?
9 月 1 日下午,42 号电波来到位于北京石景山区的一家人形机器人数据训练中心。当时正值工作日的下午,这里却四下无人,在训练中心的参观区、农业种植区以及特种区等多个区域也没有正在工作的机器人。 据多家媒体报道,该人形机器人数据训练中心已停…
对话眺月科技王方正:造一台既会跳、也会飞的机器人
还没来得及正式打招呼,眺月科技 CEO 王方正已经准备开始演示产品。 「我们先来看看这个产品吧,让它跳起来给大家演示一下。」 那是上海创新创意设计研究院的一间大会议室。长桌上摆着电脑和咖啡杯,并不是专门为机器人清理出来的测试场地。王方正把机…
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…
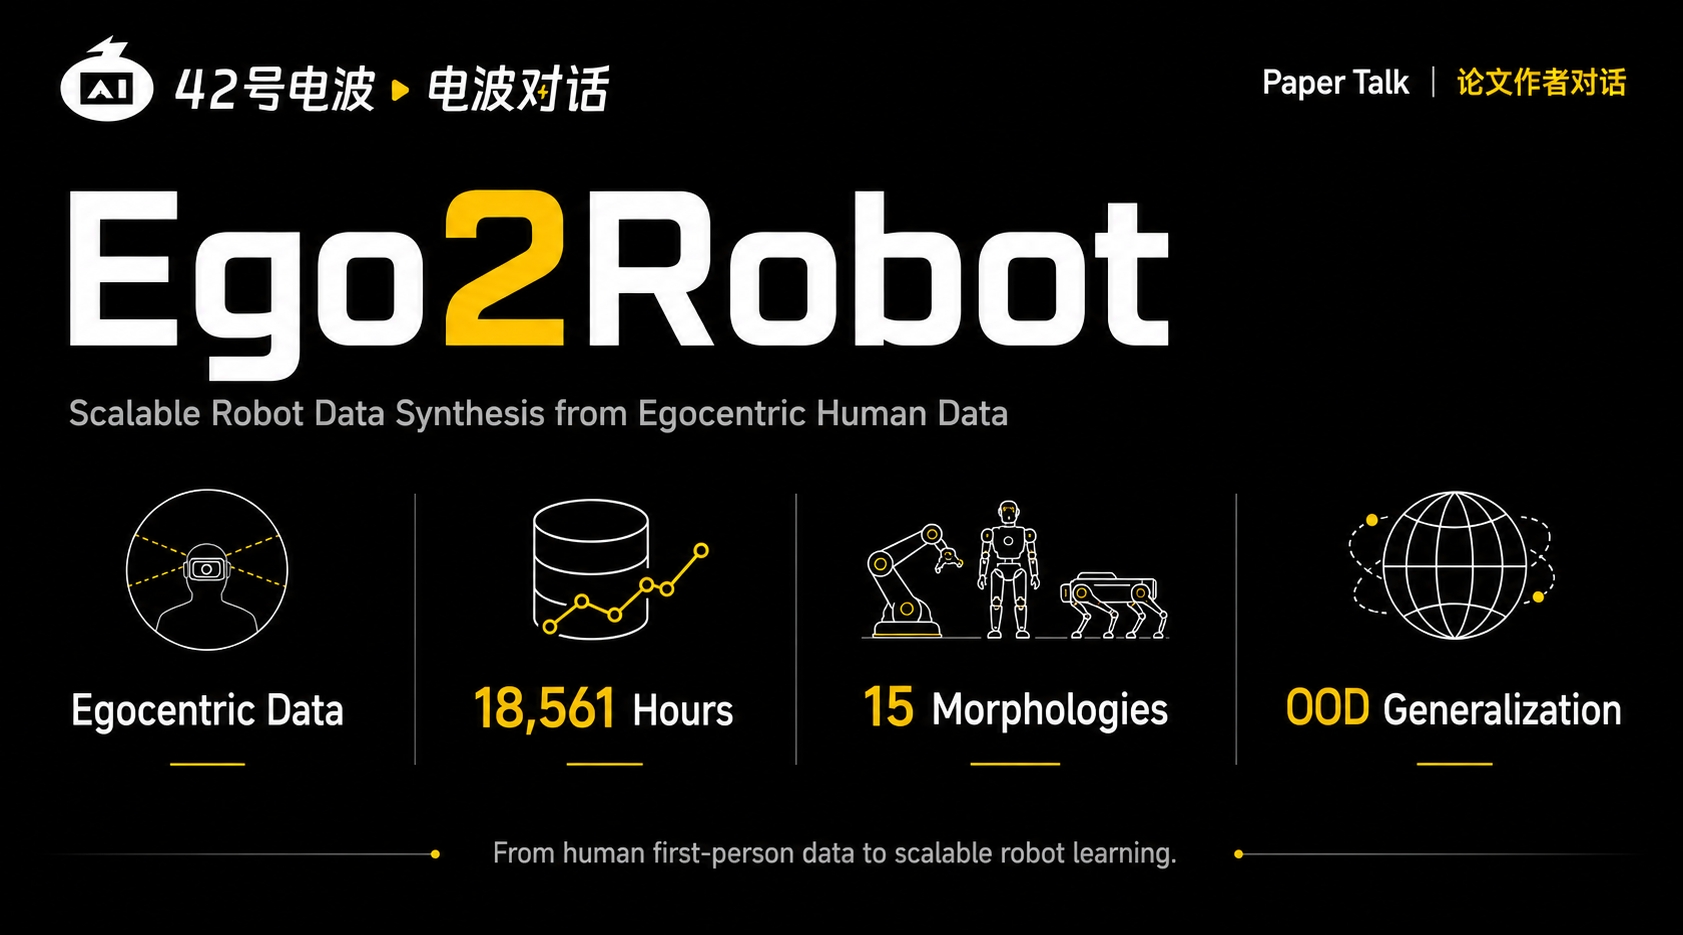
模型之外,Ego2Robot 让数据处理管线当回主角
一台机器人在固定桌面上完成任务,和换了桌布、改了光照、挪了相机位置之后仍然做对,是两种完全不同的能力。前者说明策略已经收敛,后者才决定它能不能走出实验室。 众所周知,机器人遥操作天然比人类中心视频慢、贵。而此前工作仅在小规模单任务上验证过「…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…