

编码
共 42 篇相关内容
对话 TacVLA 论文团队,触觉该在什么时候更巧妙地发挥作用?
「这种思路谁都有,但是怎么加入进来?」 在 IROS 2026 现场聊到给 VLA 增加触觉时,张恒反复关注的并不是「要不要 touch」,而是另一个更具体的问题:机器人到底应该在什么时候使用触觉? 现在给机器人装上 tactile sen…
IROS 现场对话 ULTRA 团队,机器人的「运动自由」还差什么?
灵巧手、驱动电机、控制算法、大模型......这些组成具身智能的「躯体」部件,正在变得越发精密。 以搬箱子为例,机器人的灵巧手要找到接触的位置,双脚撑住身体,电机驱动身体蹲下的同时,躯干要随重心变化调整姿态,随后再带着箱子、协调重心、缓慢移…
触觉正在成为机器人训练的下一种数据丨IROS 2026 现场
9 月 27 日,2 026 IEEE/RSJ 智能机器人与系统国际会议 IROS 在美国匹兹堡开幕,42号电波来到了现场。 好几场分会场全程座无虚席,室内席位早早被占满,会场大门一直敞开,门外还围着不少站立旁听的人。IROS 覆盖的议题很…
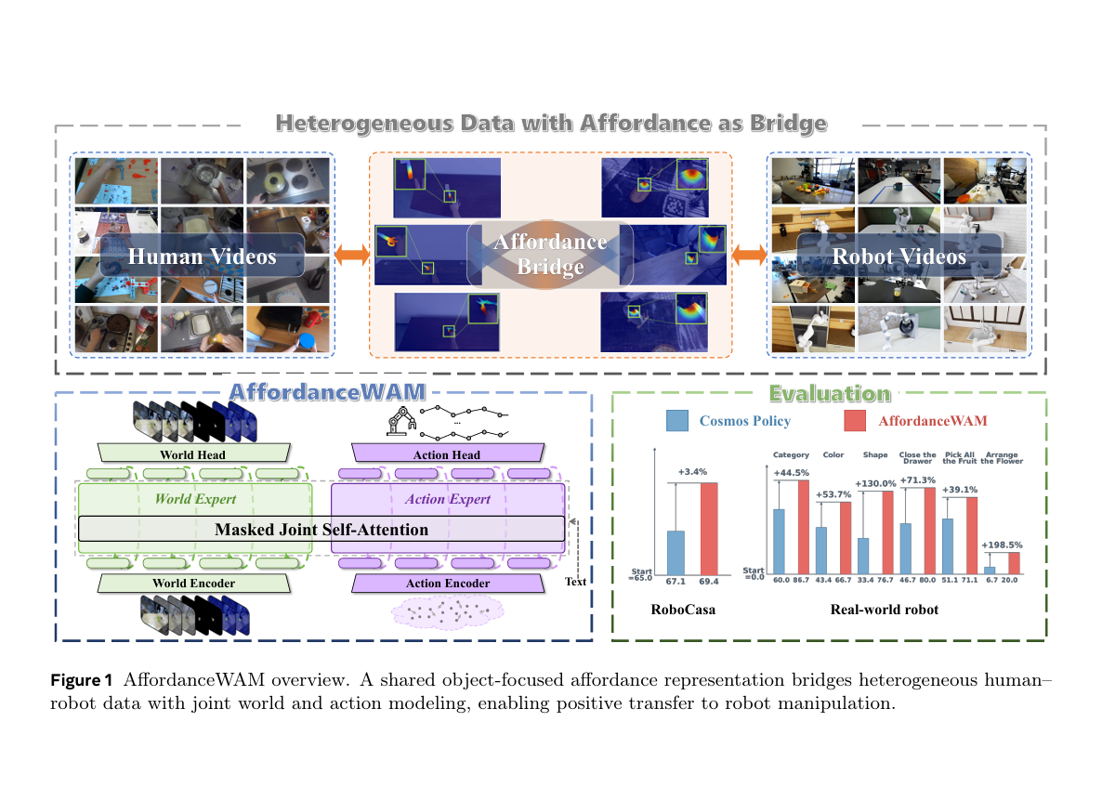
港大、港科广、北大等五校团队联合发布 AffordanceWAM,靠可供性激活真人训练视频
AffordanceWAM 的核心突破,是将「物体可交互位置与方式」的可供性,纳入世界动作模型的显式预测目标,彻底解决真人第一视角视频难以适配机器人训练的行业痛点,让原本容易造成负迁移的真人数据,转变为可规模化扩展的有效监督信号。 9 月 …
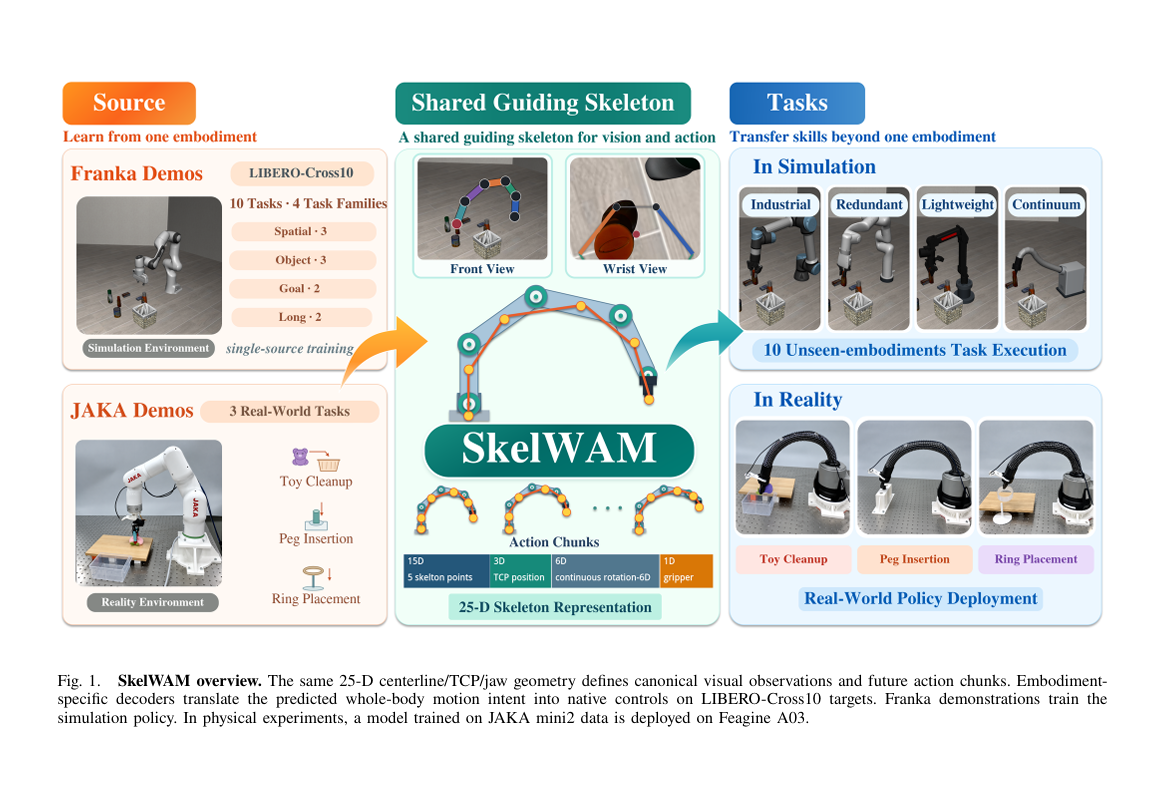
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移…
对话清华大学教授曹婷,物理自进化的「因果」与突破
9 月 21 日, 「 ICCL 自进化 · 物理智能 Open Day」 在清华大学无锡研究院智能产业创新中心举行 。 中国工程院外籍院士、清华大学智能产业研究院创始院长张亚勤罕见亮相并致辞,首创「物理自进化(PSI, Physical …
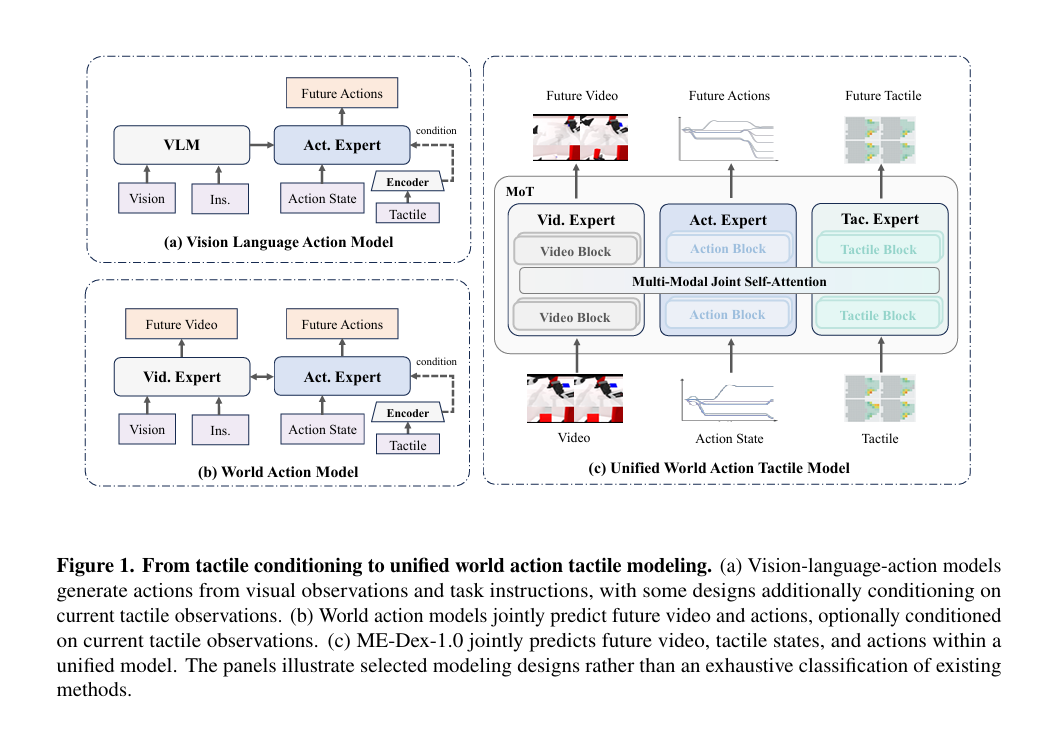
理想汽车基座模型团队提出 ME-Dex 1.0,让触觉和画面一起预测未来
ME Dex 1.0 让机器人在输出动作前,预先计算下一步会产生的接触状态。理想汽车基座模型团队将视觉、触觉、动作三路专家模块整合进同一个去噪框架;触觉与图像一样,被视作需要预测的未来观测。团队还借助手部模板,把不同灵巧手、夹爪的触觉信息对…
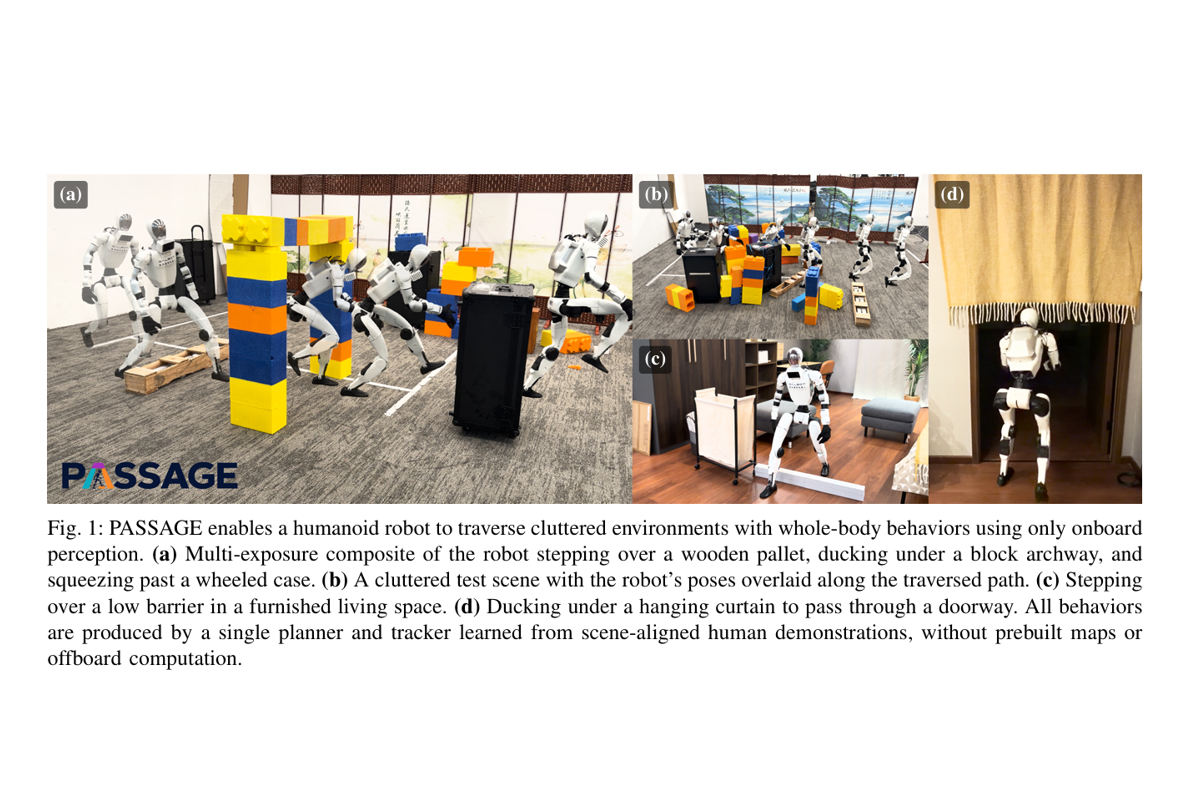
清华大学弋力团队发布 PASSAGE,让人形机器人自己挑动作穿过杂物间
PASSAGE 研究将场景对齐的人体动作数据积累至100小时量级,通过流匹配规划器搭配感知增强的全身追踪器架构,让人形机器人能够在杂乱受限环境中自主选择并组合跨越下穿侧身避让等多元运动动作。仿真测试结果可以直观证明,机器人无接触通行的成功率…

独家对话周顺波:就算没有 AGI,也能做一台大家喜欢的机器人
在创立欧拉万象以前,周顺波已经做了近 12 年机器人。 2015 年,他进入香港中文大学徐扬生院士的实验室,才真正开始做机器人。他参与研发过一只熊猫形态的疗愈机器人,后来被送进香港沙田医院,陪伴自闭症儿童和阿尔茨海默病老人。那时,这类机器人…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
0.04B 通吃异构相机,与地瓜机器人隋伟谈 X-Lens 取舍逻辑
鱼眼相机看得广但画面边缘是畸变弯曲的,针孔相机看得直但视野窄。 一台机器人身上往往同时挂着这两种相机,用于感知环境深度,而像 DAC、MapAnything 等深度估计模型,几乎没有既能同时适配好这两种相机,又能端侧跑起来的方案。 对此,地…