

机器人控制
共 17 篇相关内容
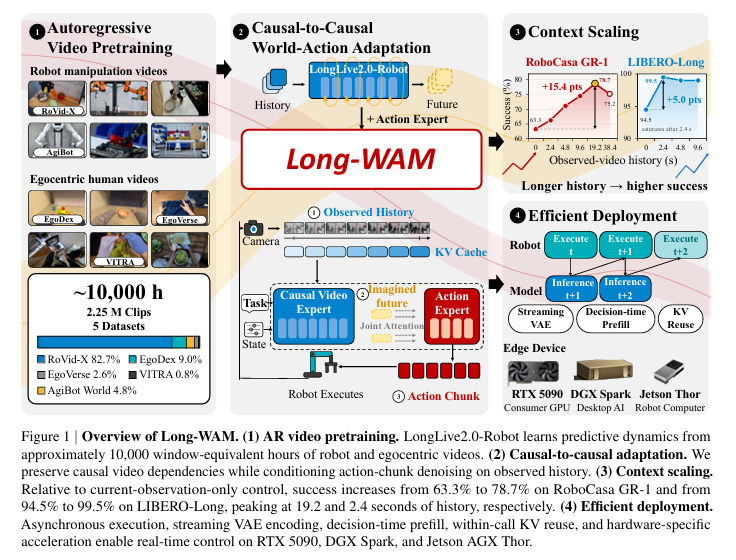
英伟达 Jim Fan 团队新作:只拉长历史解决不了 WAM 短板,核心需靠自回归预测
Long WAM 发现「能拿到历史」不等于「会用历史」:只有视频底座先以自回归方式学会从过去推未来,拉长上下文才能真正实现性能上涨。基于这一结论,团队将这套世界动作模型打造为可在边缘设备实时运行的系统。上下文时长从 0 秒拓展至 19.2 …
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
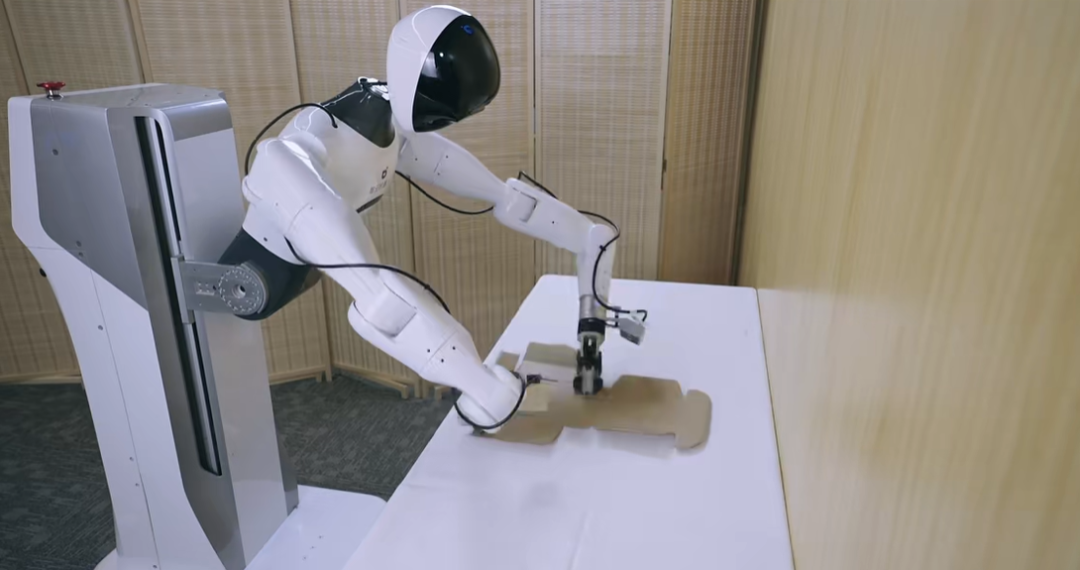
边想边做还是想好再做,智元机器人 GO-2 模型给出了答案
4 月 9 日,智元发布了新一代 VLA 基座模型 Genie Operator 2(GO 2),引入「动作思维链」和「异步双系统」架构的同时,试图为机器人领域长期存在的知行不一问题,给出一套新的解法。 近一年来,围绕机器人落地干活的讨论越…
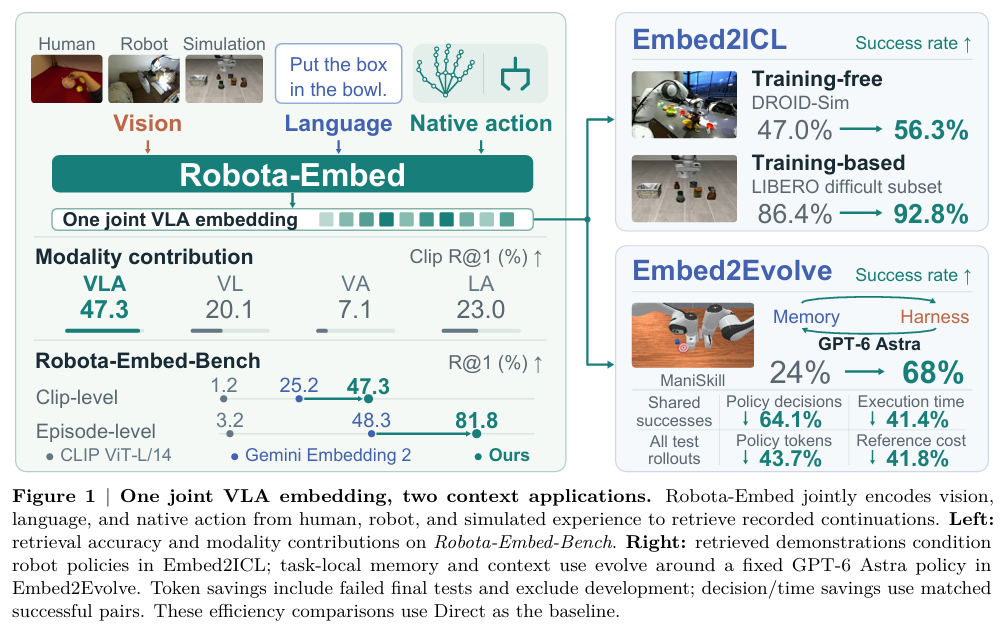
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
触觉,开始争夺传感器之外的生意
在美国匹兹堡举行的 IROS 2026 上,Sharpa 一口气发布了三款产品:一体式触觉感知灵巧操作机器人 D01、全手触觉灵巧手 W02,以及支持触觉反馈的外骨骼数据手套 AE01。 Sharpa 联合创始人李一帆此前在接受采访时曾表示…
智在无界卢宗青团队提出 Being-M0.7,依托人类视频动作先验,训练人形机器人全身移动操作
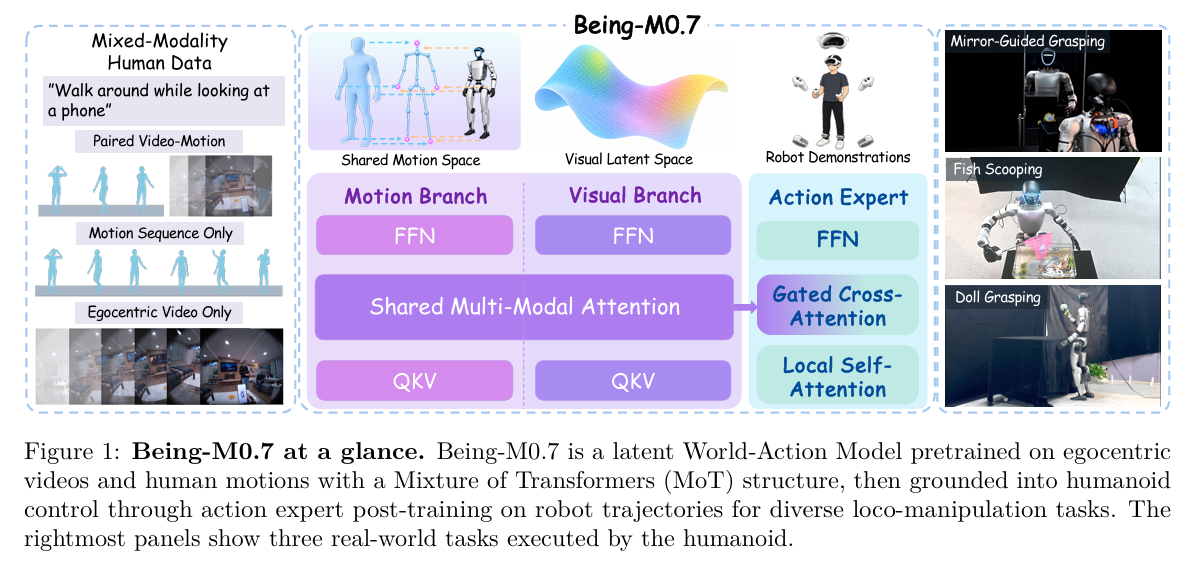
Being M0.7 依托一万余小时人类第一视角视频与人体动作数据,学习画面与全身动作的联合先验,再通过机器人轨迹完成中训与动作后训练,输出人形机器人全身移动 + 操作的控制指令。模型在 SIMPLE 仿真基准中综合成功率 71.1%,位列…
对话清华大学教授曹婷,物理自进化的「因果」与突破
9 月 21 日, 「 ICCL 自进化 · 物理智能 Open Day」 在清华大学无锡研究院智能产业创新中心举行 。 中国工程院外籍院士、清华大学智能产业研究院创始院长张亚勤罕见亮相并致辞,首创「物理自进化(PSI, Physical …
399 美元买一只会摔跤的鸭子,Hugging Face 赌的是机器人的「刷机时代」
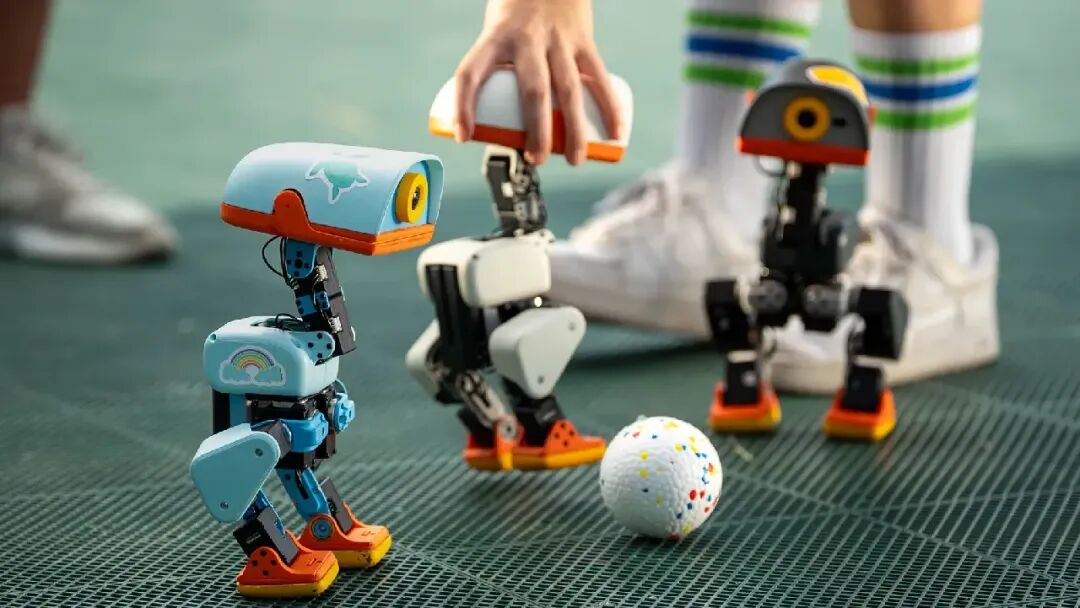
399 美元,买不到一台替你叠衣服、收拾房间的人形机器人。 但可以买到一只鸭子。 它只有 25 厘米高,走起路来摇摇摆摆;脑袋和身体一共装了 15 个电机,嘴巴可以张开,把地上的小东西铲起来。它会坐下、站起、踢球、滑旱冰,也可以从多种常见摔…
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…
不止于预测,小米将世界模型打造成数据引擎
7 月 14 日,小米放出其自研机器人在工厂中连续作业的任务视频,视频中可以看到机器人在面对不同尺寸工件依然可以长时间稳定作业。 然而,机器人在工厂里的稳定作业,只是最终呈现出来的结果。真正支撑这一结果的,是机器人背后的模型能力。模型能力决…
把 Codex、CC 搬进机器人训练? 朱玉可、Jim Fan 最新力作谈具身持续学习系统
让机器人去拿一罐可乐,听起来像一件很小的事。 但行动的每一步都可能翻车:没看清可乐罐,抓取姿态歪了,路径规划撞到了桌角,手指夹住了空气,或者好不容易拿起来,下一秒又把它放错了地方。 最后给你一句很没用的反馈:任务失败 。 这就像程序崩了,但…
与 OpenAI 分道扬镳后,Figure 机器人反而更强了?
最近,Figure 创始人 Brett Adcock 参加了播客节目《Shawn Ryan Show》,在长达 3 小时的访谈中,Brett Adcock 就机器人技术路径、产业应用和 AI 泡沫等问题进行了详细探讨。 作为全球估值最高(3…