
 EN
第一视角
共 42 篇相关内容
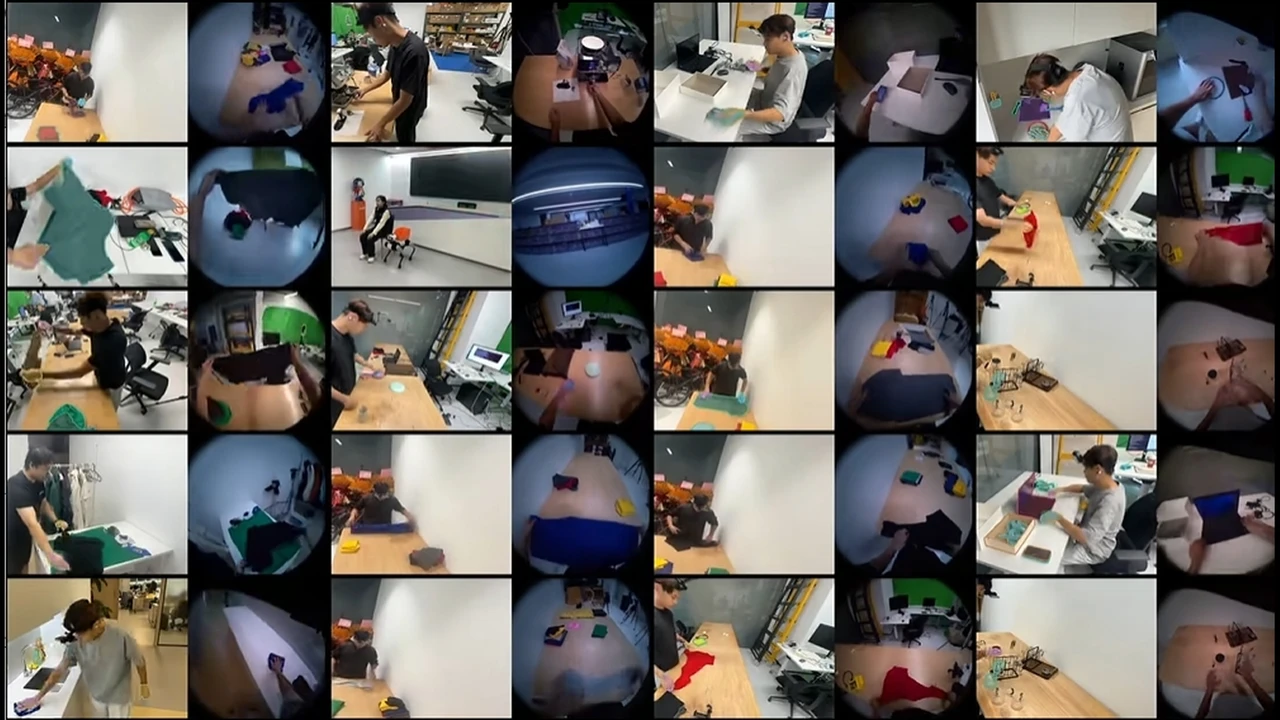
硅谷争抢第一视角数据,中国 AI 从旧视频里找答案
具身智能的数据荒,最近出现了一种新的解题思路:绕过第一视角采集。 过去一年,第一视角人类视频成为机器人公司重点争夺的数据资源。但获得这些数据并不容易。第一视角视频通常需要通过头戴相机等设备采集,随着任务、人员和环境不断扩展,设备投入、采集组…
Kosmo 与 Ropedia 合作,将三维场景与人类操作记录对齐
11 月 13 日,三维空间数据引擎 Kosmo 与物理 AI 数据公司 Ropedia 宣布达成战略合作。双方将结合真实场景的三维扫描与第一视角任务记录,为物理 AI 模型提供空间结构和人类操作过程相互对应的数据。 具身模型要在真实环境中…
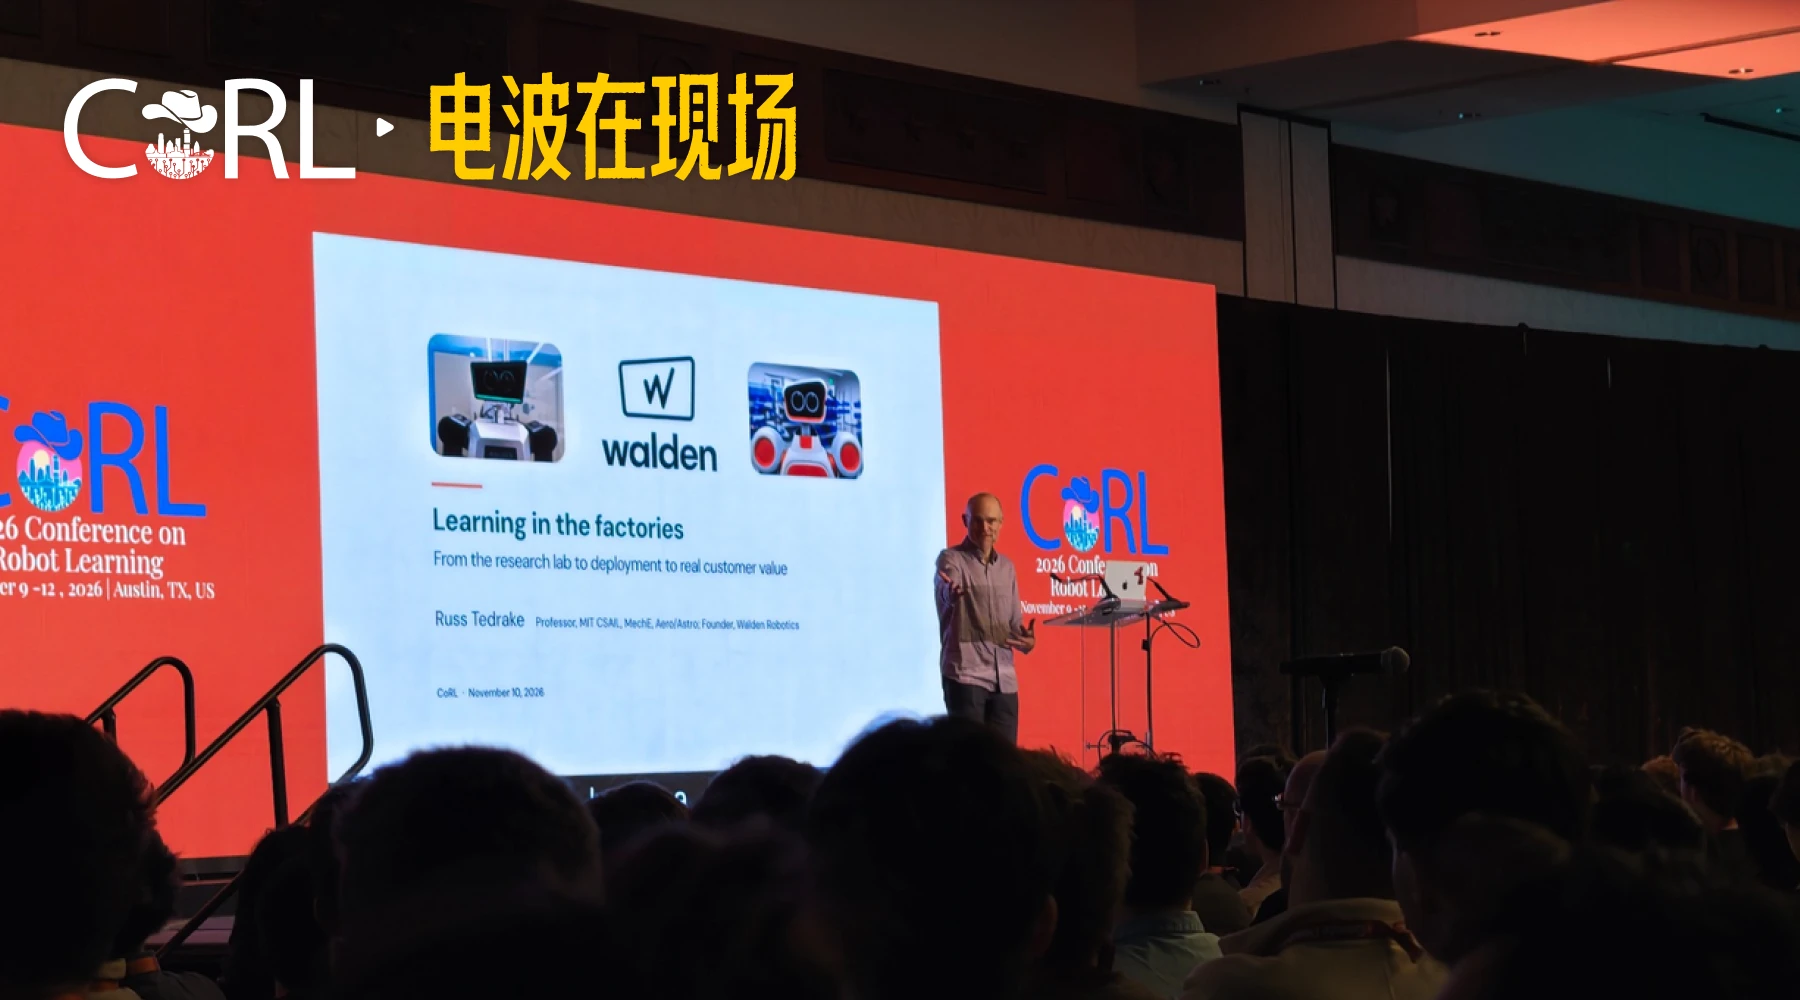
从丰田研究院走进工厂,Walden 在真实部署中改进机器人丨CoRL 2026
美国当地时间 11 月 10 日,机器人学习顶会 CoRL 2026 在得克萨斯州奥斯汀开幕。 在本次大会的议程中,Walden 联合创始人兼 CEO、麻省理工学院教授 Russ Tedrake,带来题为《Learning in the f…
Jim Fan 喊出「凛冬将至」,机器人公司还要自研大脑吗?
「我从没见过人类历史上有这样一个东西,能打碎这么多梦想。」 美国当地时间 11 月 9 日,在 CoRL 2026 机器人学习大会上,NVIDIA GEAR 研究团队负责人 Jim Fan 用这样一段玩笑开启演讲。 他用「悲伤的五个阶段」描…
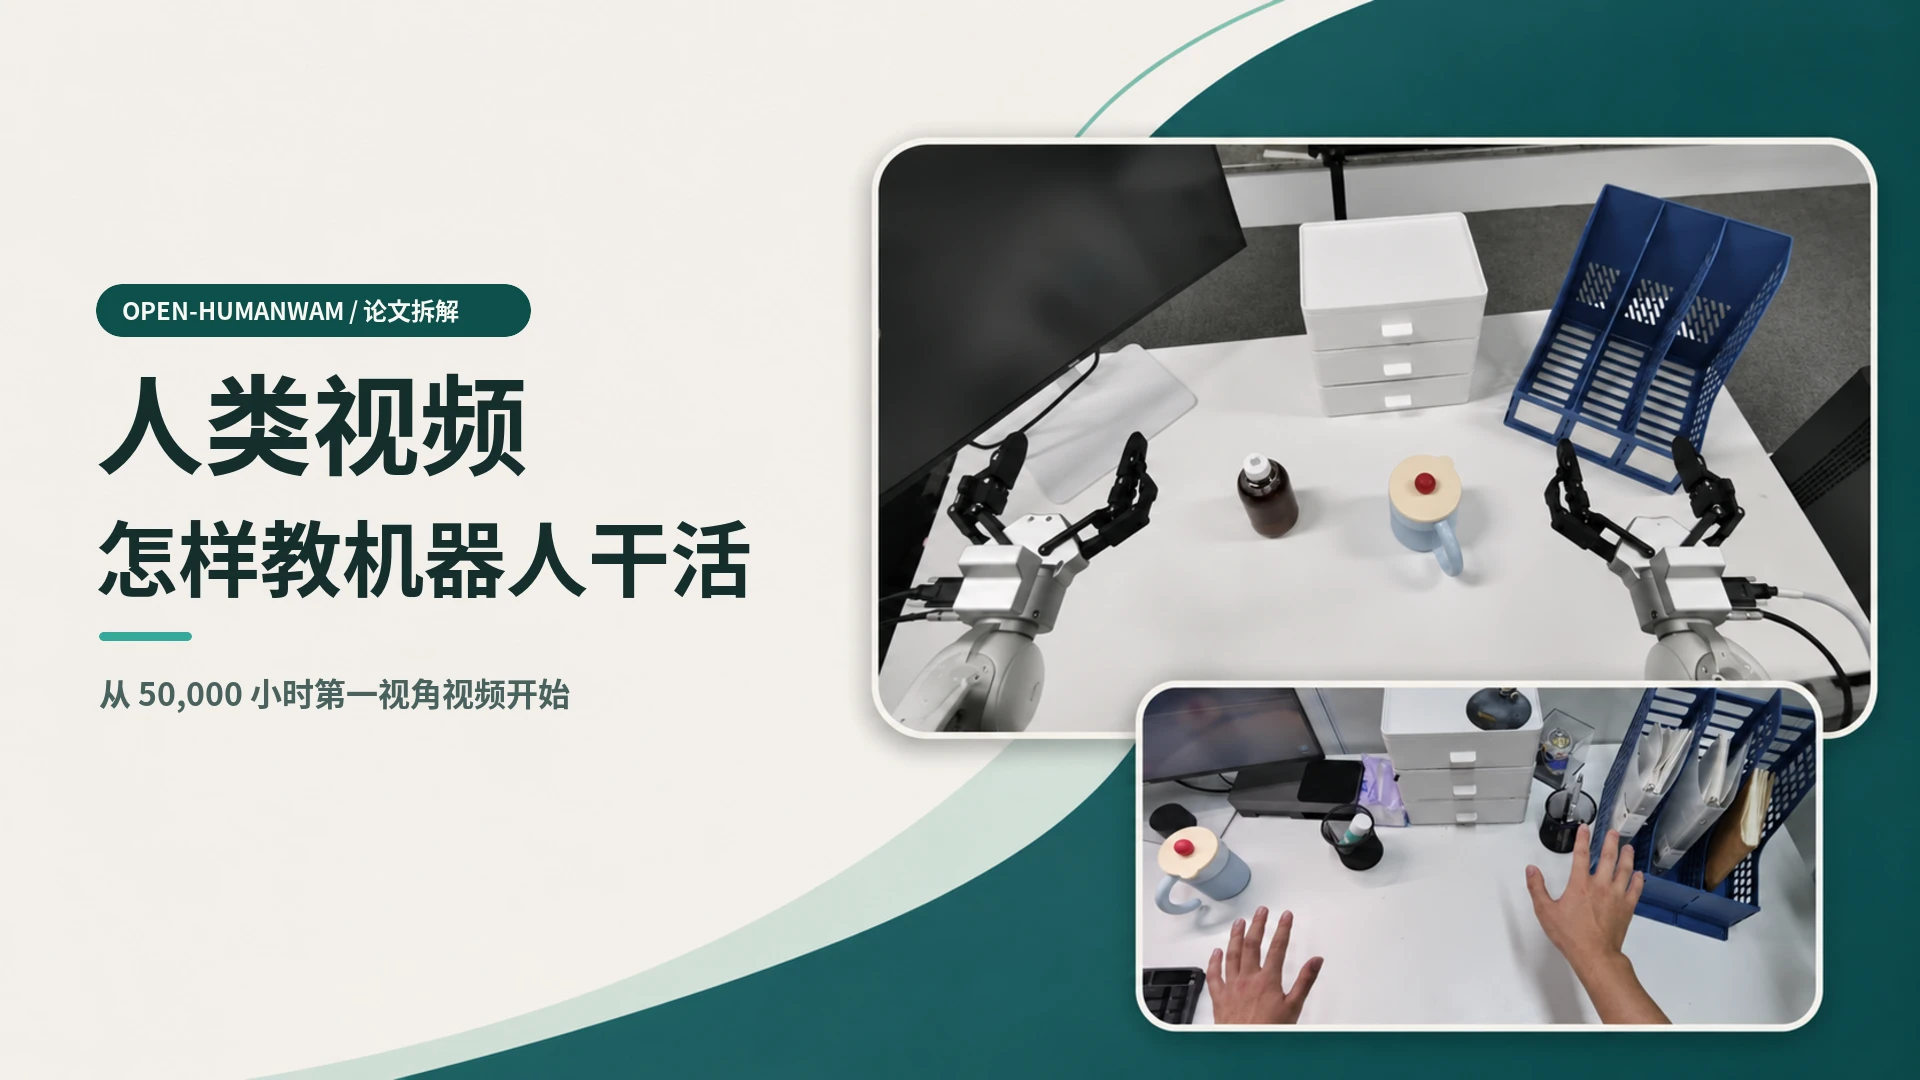
北大团队提出 Open-HumanWAM,纯人数据训出机器人底座
人类视频里有大量拿取、收纳和整理的过程,机器人怎样从这些视频里学到能用的操作经验? 11 月 5 日,北京大学联合新加坡国立大学、麻省理工学院、加州大学圣迭戈分校与英伟达发表论文《Open HumanWAM: An Open Recipe …
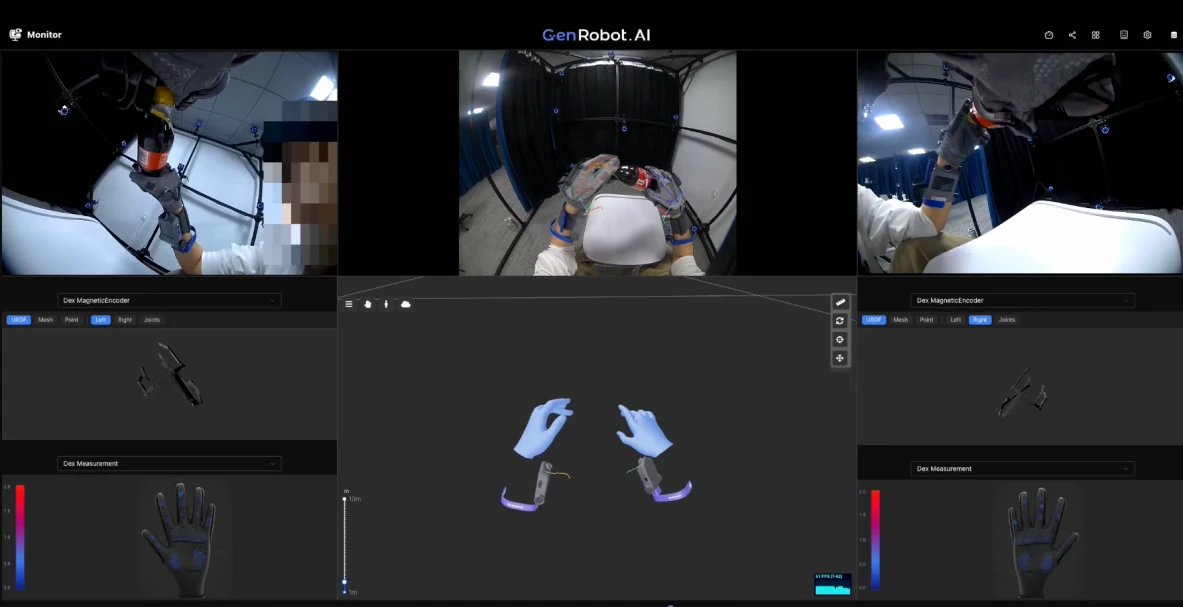
简智机器人 DAS 2.0 将亮相 CoRL,覆盖头手协同与全身数据采集
11 月 9 日,简智机器人在美国奥斯汀举办的 CoRL 会议上正式展出 DAS 2.0 系列。新品包含新一代灵巧手数据采集手套 DAS Dex 2.0,以及新一代第一视角多模态采集设备 DAS Ego 2.0。两套设备协同捕捉环境画面、手…
LiberAI 发布 Liber-0,打通人类动作经验到机器人
11 月 4 日,物理世界模型初创公司 LiberAI 正式发布世界动作模型 Liber 0。 根据官方信息,Liber 0 在超 220 万小时的人类经验数据上完成预训练。团队采用 GPT 6 提出的 60 项操作任务做零样本评测:任务分…
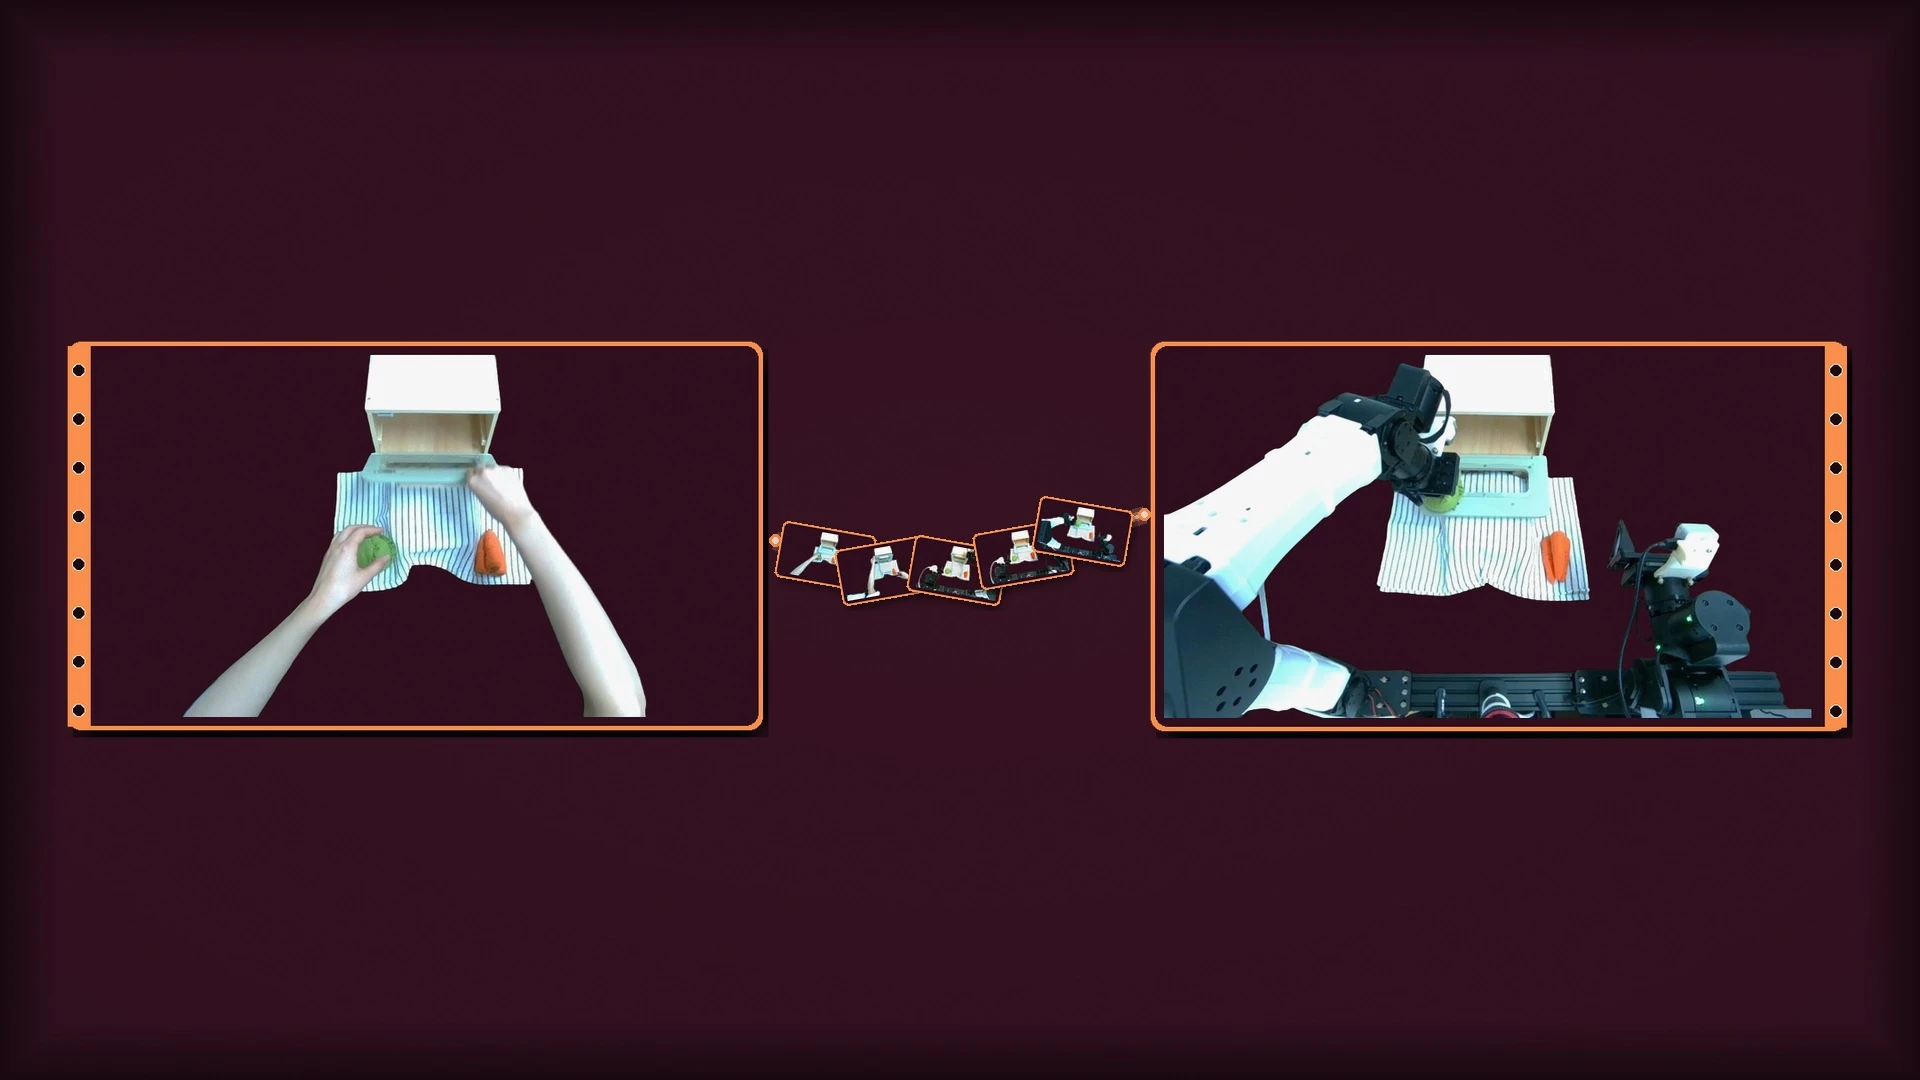
英伟达提出 ThinkWorld,把动作写成链,用想象的未来判对错
机器人演示采集成本高,覆盖的场景和动作有限。互联网上虽然有大量人类第一视角视频,却零散杂乱,也没有机器人可以直接执行的动作标签。VLA 怎样吸收这些视频里的操作经验? 针对这个问题,英伟达联合 KAIST(韩国科学技术院),于 10 月 2…
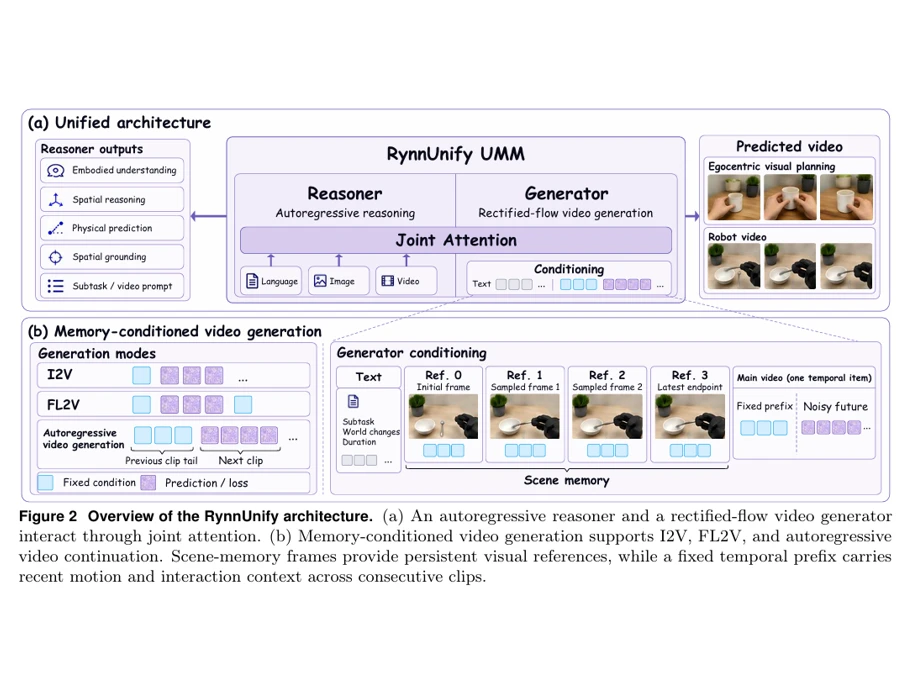
8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑?
主:8B 负责推理,8B 负责「想象」:达摩院给机器人搭了个什么大脑? 副:大模型,开始用视频打草稿 小红书正文 对于机器人来说,脑补被遮挡的物体实在太难了。10 月 23 日,阿里巴巴达摩院团队联合湖畔实验室发表论文《迈向统一具身大脑》(…
自然意志物理基模 Natura-1 首次亮相:技术、启发与幕后故事
自然意志物理基模 Natura 1 首次亮相:技术、启发与幕后故事 10 月 13 日,由清华大学电子工程系助理教授、博士生导师丁宁创办的自然意志(Nature Will)发布了成立以来首个通用具身基础模型 Natura 1 及技术报告,引…
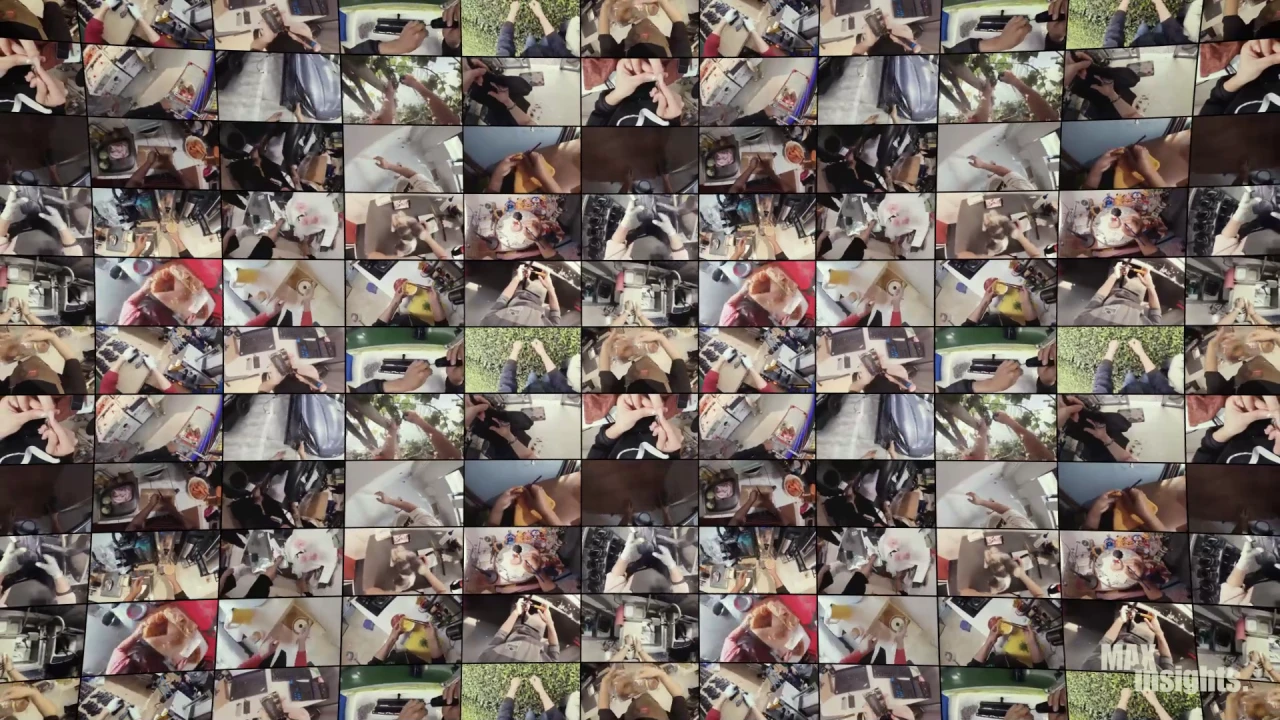
机器人训练数据公司 Maxinsights 完成 3,000 万美元种子轮融资,Peak XV 领投
美东时间 10 月 22 日,总部位于美国加州圣克拉拉的机器人训练数据公司 Maxinsights 宣布完成 3,000 万美元种子轮融资,由 Peak XV 领投,Tola Capital、South Park Commons、渶策资本和…
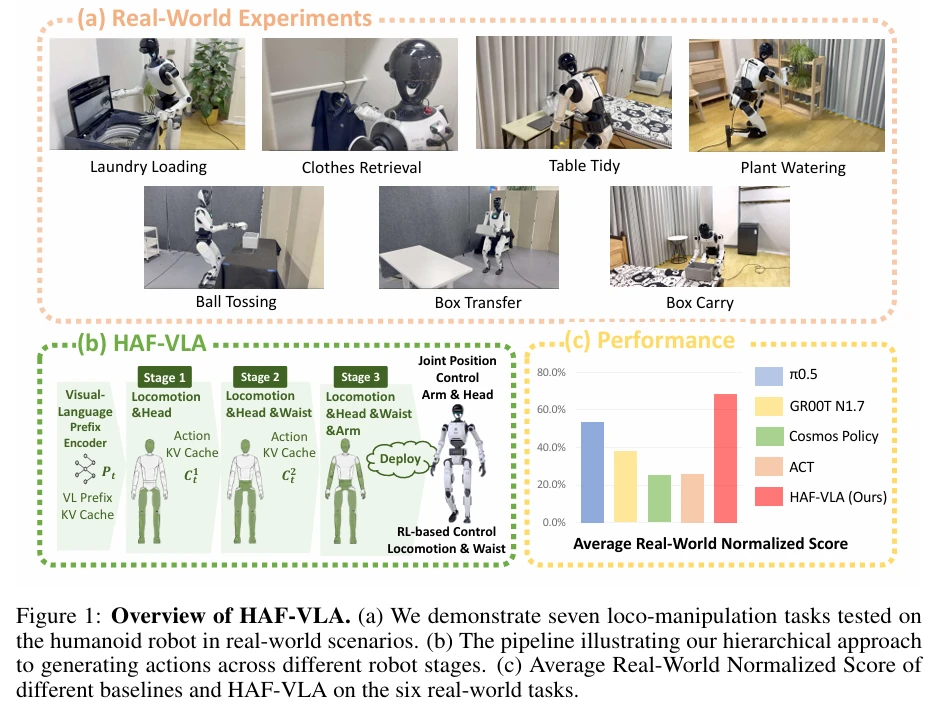
仉尚航等提出 HAF-VLA,让人形机器人分层生成协调的全身动作
仉尚航等提出 HAF VLA,让人形机器人分层生成协调的全身动作 人形机器人要学会自主走向目标、俯身、再伸手抓取,卡点在于全身动作的协同生成。腿、腰、头部与双臂串联在同一条运动学链上:底盘偏移几厘米、腰部角度差几度,手臂就得伸得更远代偿。持…