

蒸馏
共 12 篇相关内容
DreamFree 依托表征蒸馏,脱离未来视频生成实现机器人控制
机器人想要学会操作,首先要预判场景接下来会如何变化。不少世界动作模型会借助预训练视频扩散模型完成这件事:先脑补出未来画面,再依据画面输出动作。但生成想象画面是部署阶段成本最高的环节,生成一组动作序列需要执行数十步去噪。一旦想象的画面出现偏差…
清华团队提出 Utility-WAM,按需启用未来视频做机器人动作规划
把「先想几帧未来画面,再出动作」写进策略,是具身智能近两年很受关注的技术路线。机器人可以在模型内部推演后续场景画面,让动作规划获得动态前瞻能力,理论上更适配长程、多阶段任务。 但是,预测未来画面会改动模型输出的动作,改动有好有坏,正负效果互…
依托世界模型倒带复盘,智元 Rollback 让单台真机 8 小时追上人类均值
机器人一旦做错决策,能不能退回节点换个动作重新尝试? 这在现实物理世界很难,就像积木塔一旦倒塌,不会自己复原。机器人每试错一次,都要人工重置场景、把道具摆回初始状态,才能开启下一轮试验。 大量时间和成本都耗在场景复位上,这正是实体机器人强化…
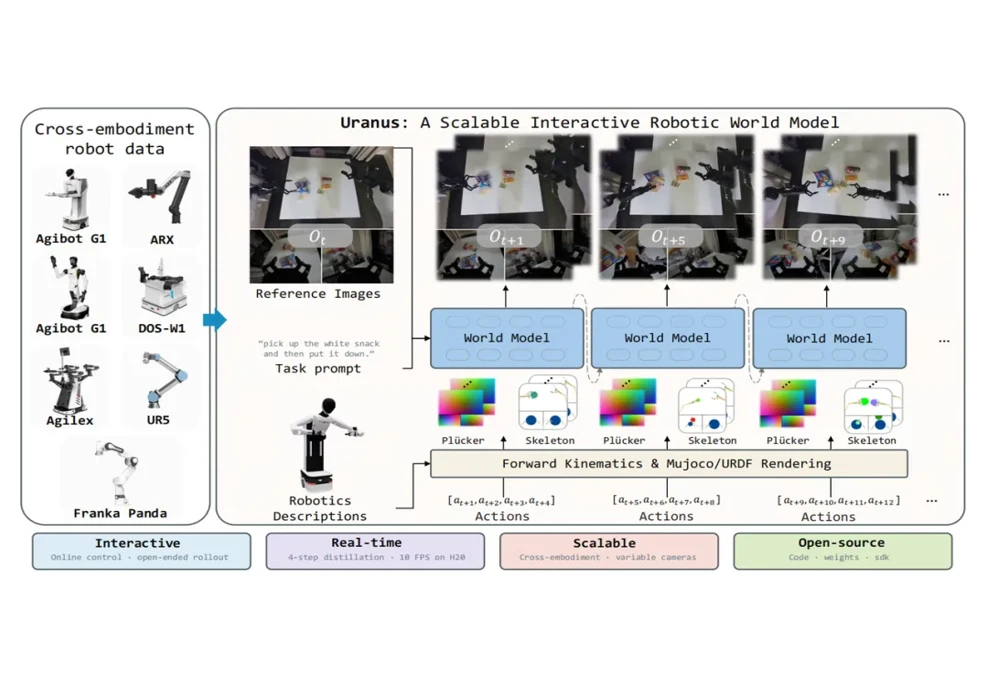
地瓜机器人开源 Uranus 世界模型仿真平台,RoboTwin 闭环评测相关性达 0.98
10 月 27 日,地瓜机器人大模型团队开源 Uranus 技术报告,并同步开放推理代码、SDK 和模型权重,面向全球开发者与研究者开放 100 个早期体验名额。Uranus 面向机器人策略的交互测试与比较:真机实验受设备、周期和安全条件限…
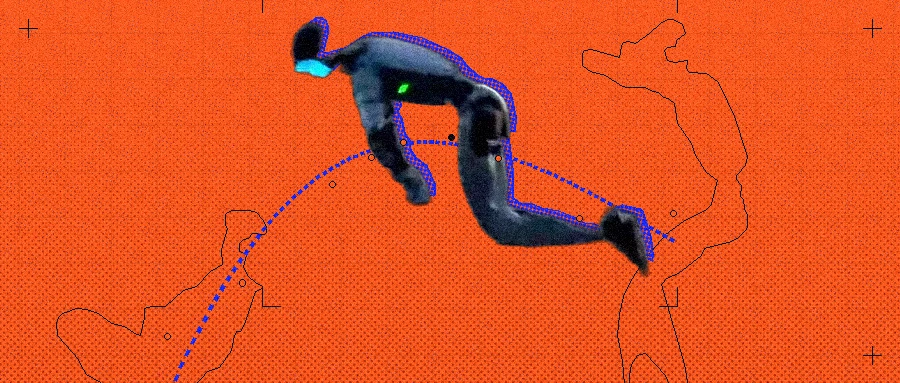
具身智能前沿取得重大突破!SuperMimic 或为机器本体扫清算力障碍
10 月 21 日,加州大学伯克利分校(UC Berkeley)团队公开论文《SuperMimic: Scaling Humanoid Whole Body Control with One Differentiable World Mod…
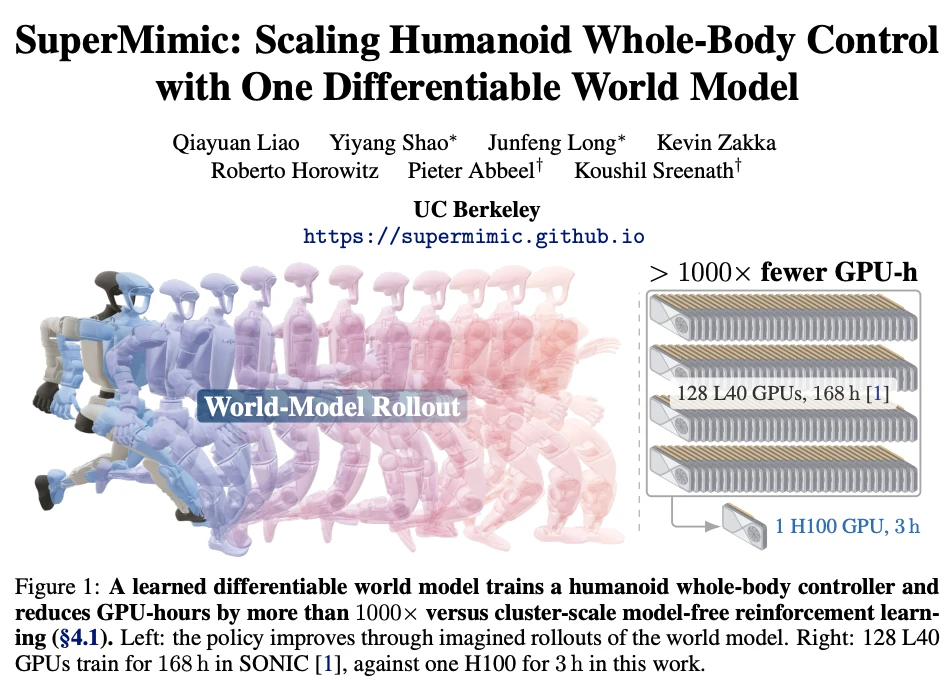
UC Berkeley 团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线
UC Berkeley 团队提出 SuperMimic,单卡训练 3 小时超越 128 卡基线 人形机器人想要掌握行走、跳跃乃至空翻,背后需要多大的训练算力? 过去的常规做法,是让机器人在模拟器内不断试错,依靠强化学习优化动作控制策略。动作…

对话 Shallow-π 作者:压缩 Transformer 层级,具身模型竟做得更好?
一个圆柱、一块正在转动的孔板,足以让两种机器人模型拉开差距。 在 Shallow π 的真实机器人实验中,任务要求机械臂拿起圆柱,插入移动中的小孔。层数更多的大模型,可能在等待计算结果的过程中错过位置;一个层数更少、输出接近它的小模型,却能…
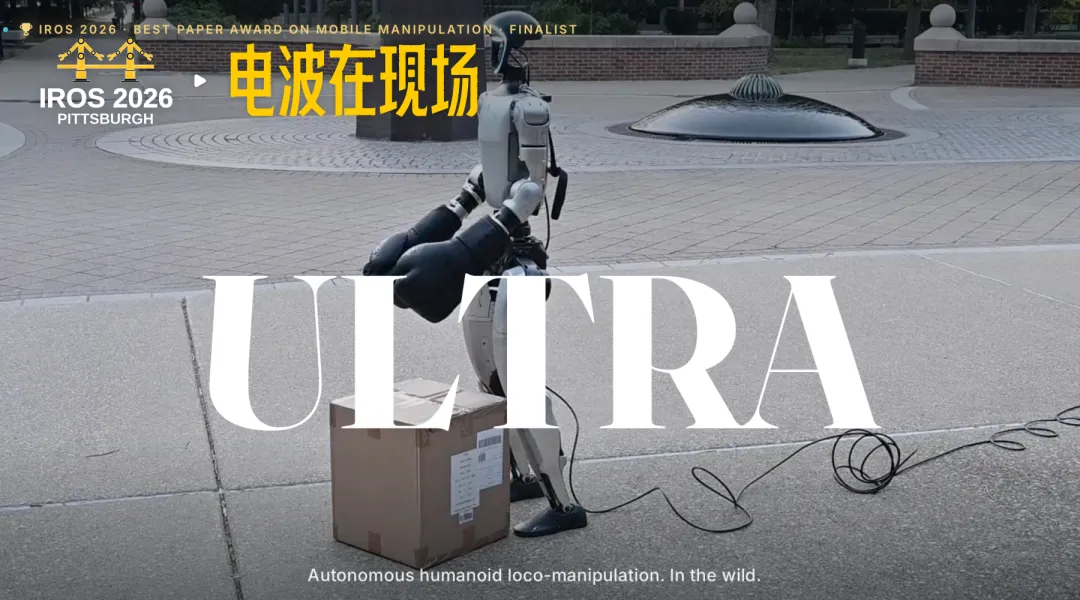
IROS 现场对话 ULTRA 团队,机器人的「运动自由」还差什么?
灵巧手、驱动电机、控制算法、大模型......这些组成具身智能的「躯体」部件,正在变得越发精密。 以搬箱子为例,机器人的灵巧手要找到接触的位置,双脚撑住身体,电机驱动身体蹲下的同时,躯干要随重心变化调整姿态,随后再带着箱子、协调重心、缓慢移…
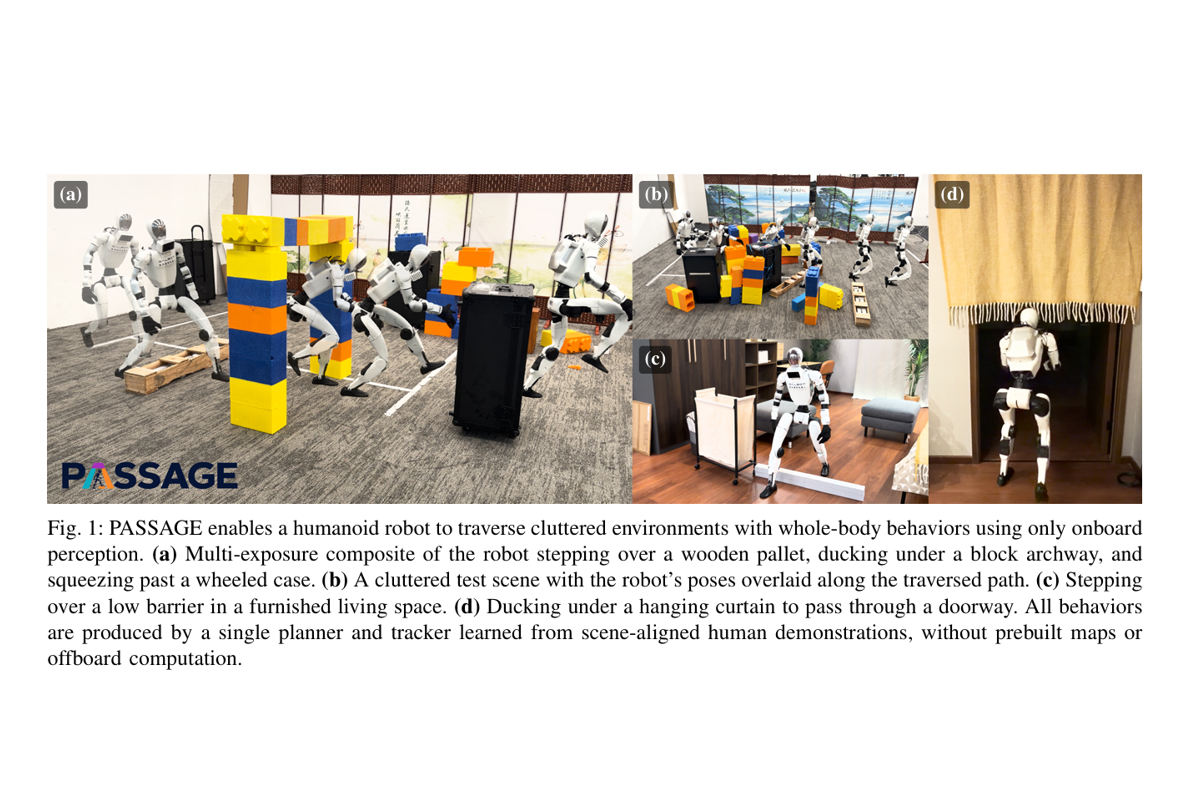
清华大学弋力团队发布 PASSAGE,让人形机器人自己挑动作穿过杂物间
PASSAGE 研究将场景对齐的人体动作数据积累至100小时量级,通过流匹配规划器搭配感知增强的全身追踪器架构,让人形机器人能够在杂乱受限环境中自主选择并组合跨越下穿侧身避让等多元运动动作。仿真测试结果可以直观证明,机器人无接触通行的成功率…
对话上海交大杨理欣:为什么机器人需要一条「三维时间轴」
机器人会倒水,却可能在放下瓶子后忘了刚才倒过哪一瓶。会执行动作,不等于知道任务该如何推进;机器人还需要把任务意图、行动历史与世界变化连成一条三维时间线。 这类失败不完全是抓取精度问题。今天的视觉—语言—动作模型(Vision Languag…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
银河通用推出 AstraBrain-WBC 0.5 — 人形机器人「小脑」的 GPT 时刻
小脑之于人体,如同 AstraBrain WBC 0.5 之于机器人 —— 负责全身运动控制。 6 月 19 日,银河通用正式推出全球首个面向人形机器人的通用小脑基础模型—— AstraBrain WBC 0.5 。该模型被定义为人形机器人…