

执行
共 144 篇相关内容

智元为什么突然成了机器人运动会的「奖牌收割机」?
8 月 26 日晚间,为期五天的第二届世界人形机器人运动会在北京闭幕,来自 16 个国家的 666 支队伍、2,056 台机器人参加了本届运动会。 究竟哪一支队伍更强?奖牌榜说了算。本届人形机器人运动会上,共诞生了 50 枚金牌、49 枚银…
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…

独家对话周顺波:就算没有 AGI,也能做一台大家喜欢的机器人
在创立欧拉万象以前,周顺波已经做了近 12 年机器人。 2015 年,他进入香港中文大学徐扬生院士的实验室,才真正开始做机器人。他参与研发过一只熊猫形态的疗愈机器人,后来被送进香港沙田医院,陪伴自闭症儿童和阿尔茨海默病老人。那时,这类机器人…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
中美韩三篇具身智能体力作,串起机器人 Agent 的现在与未来
近期,随着 Anthropic 发布报告,具身智能的牌桌上坐满了所有能叫出名字的大语言模型巨头。 Anthropic 在 2026 年 7 月发布了一份独特的实验报告《Claude plays robotics》。他们直接把 Claude …
杨立昆点赞,浙大孙俊涵、清华赵昊等提出 INTACT:免去 JEPA 世界模型的「搜索税」
世界动作模型的核心在于,先预测「下一步发生什么」,并为其设立目标,再让机器人看一眼目标,自己决定执行的每一步该做什么。 然而当前的主流方案有一个别扭的设计:训练时,模型学会「给定当前画面和动作,预测接下来发生什么」;部署时,控制器却从随机噪…
首次!北大、南洋理工等 30 位研究者联手厘清具身数据金字塔
7 月 28 日,来自北京大学、南洋理工、港科大、新加坡国立、港大、上海交大等十余所机构的近 30 位研究者联合发布了一篇 72 页长文综述《Data Pyramid for Embodied Manipulation》。该综述通过一个五层…
50 万小时第一视角视频,如何给具身世界模型补上「触觉」
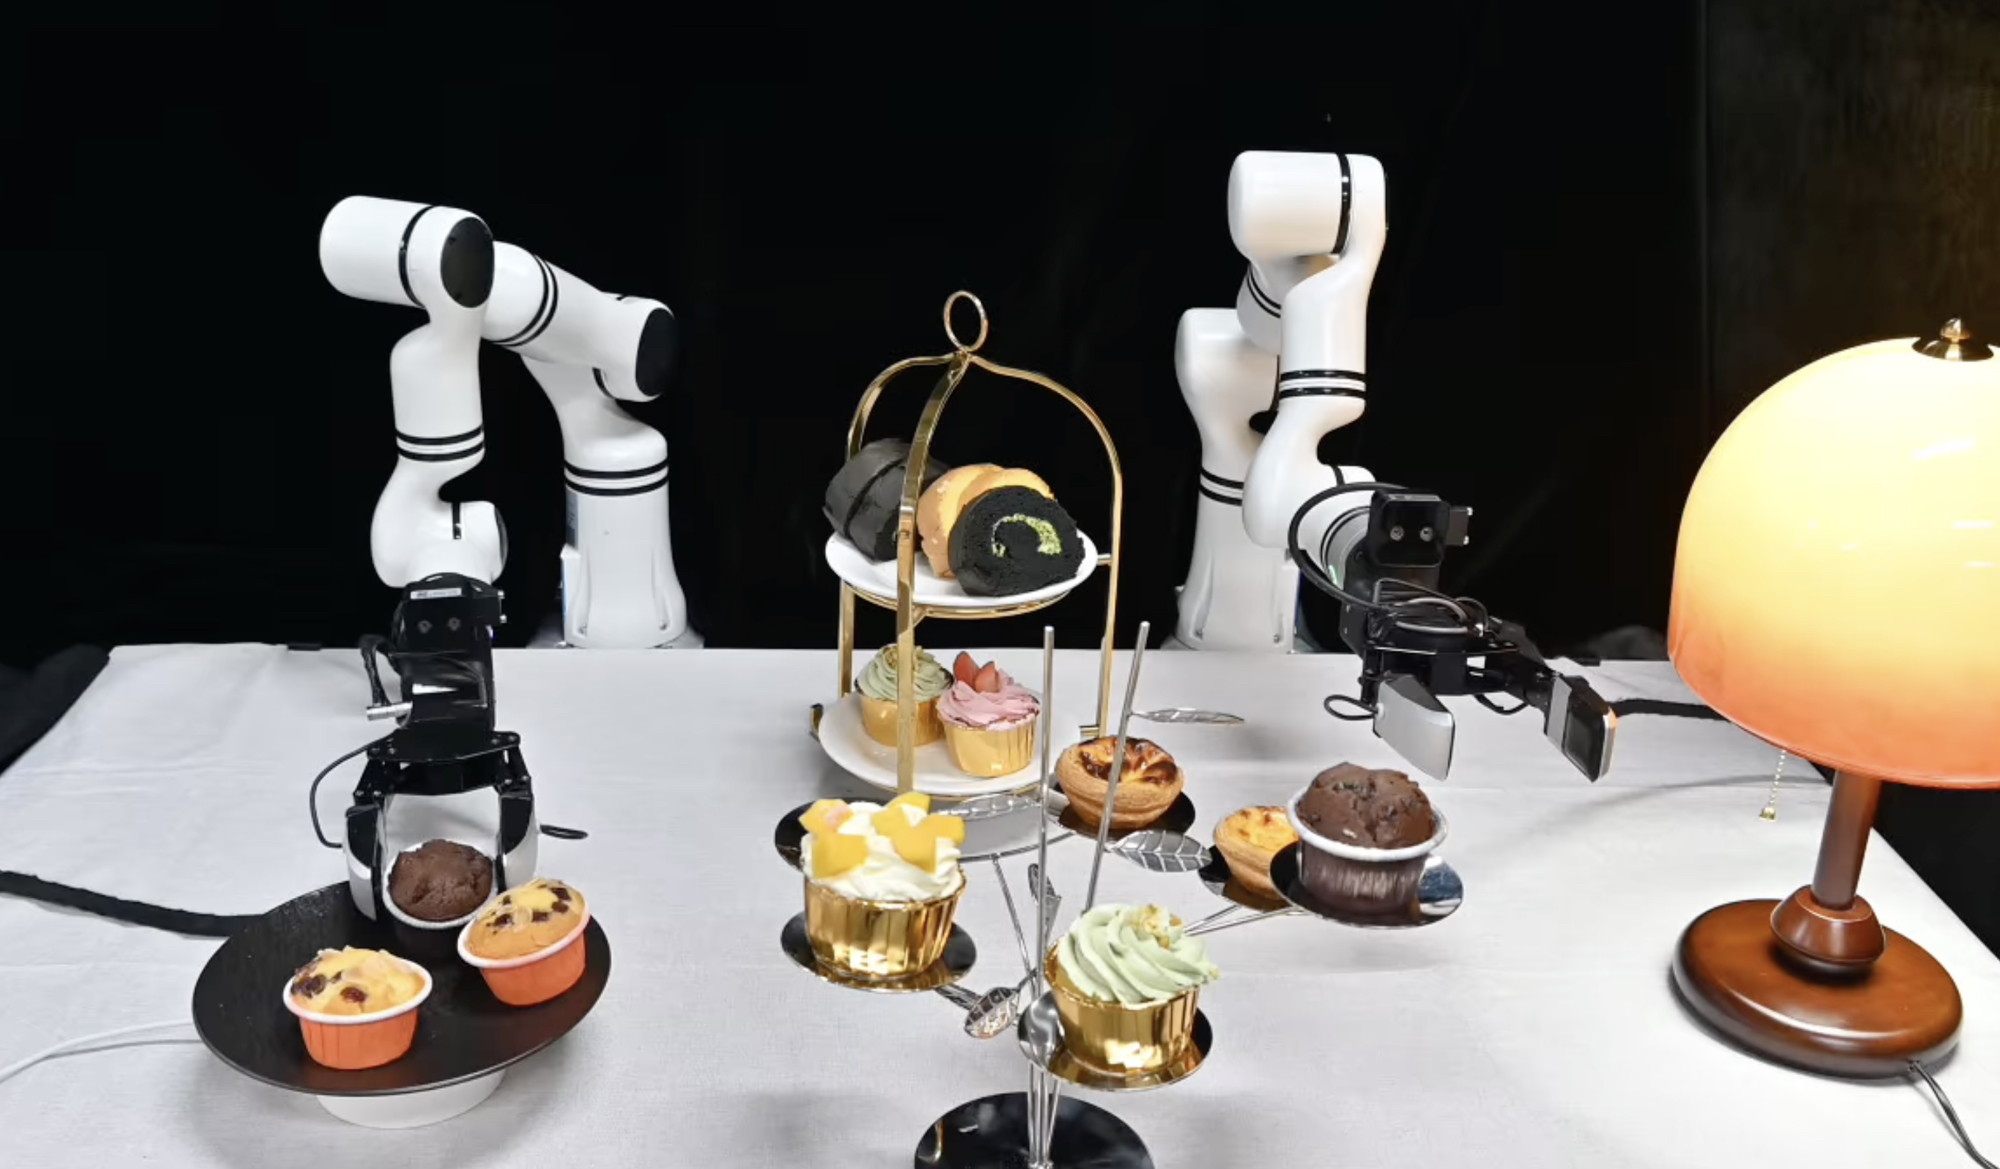
一只机械手把葡萄从一串果实中摘下来,难点不在于「看见」葡萄,而在于何时接触、哪根手指承力、力道多大才不会把果肉捏坏。挤牙膏、从软袋里摸出被遮住的物品、用软笔写字,都是同一类问题:视觉能描述物体和姿态,却很难直接给出接触已经发生了没有、接下来…

一次开源三大模型,腾讯机器人正在「超车」
继 2025 年 WAIC 腾讯 Robotics X 实验室发布首个模块化具身智能开放平台 Tairos,在今年 WAIC 上,腾讯 Robotics X 实验室、福田实验室联合腾讯混元发布具身智能系列新成果。 新成果包括发布并开源基于混…
宇树新大脑首秀,全身智能从概念走向真机
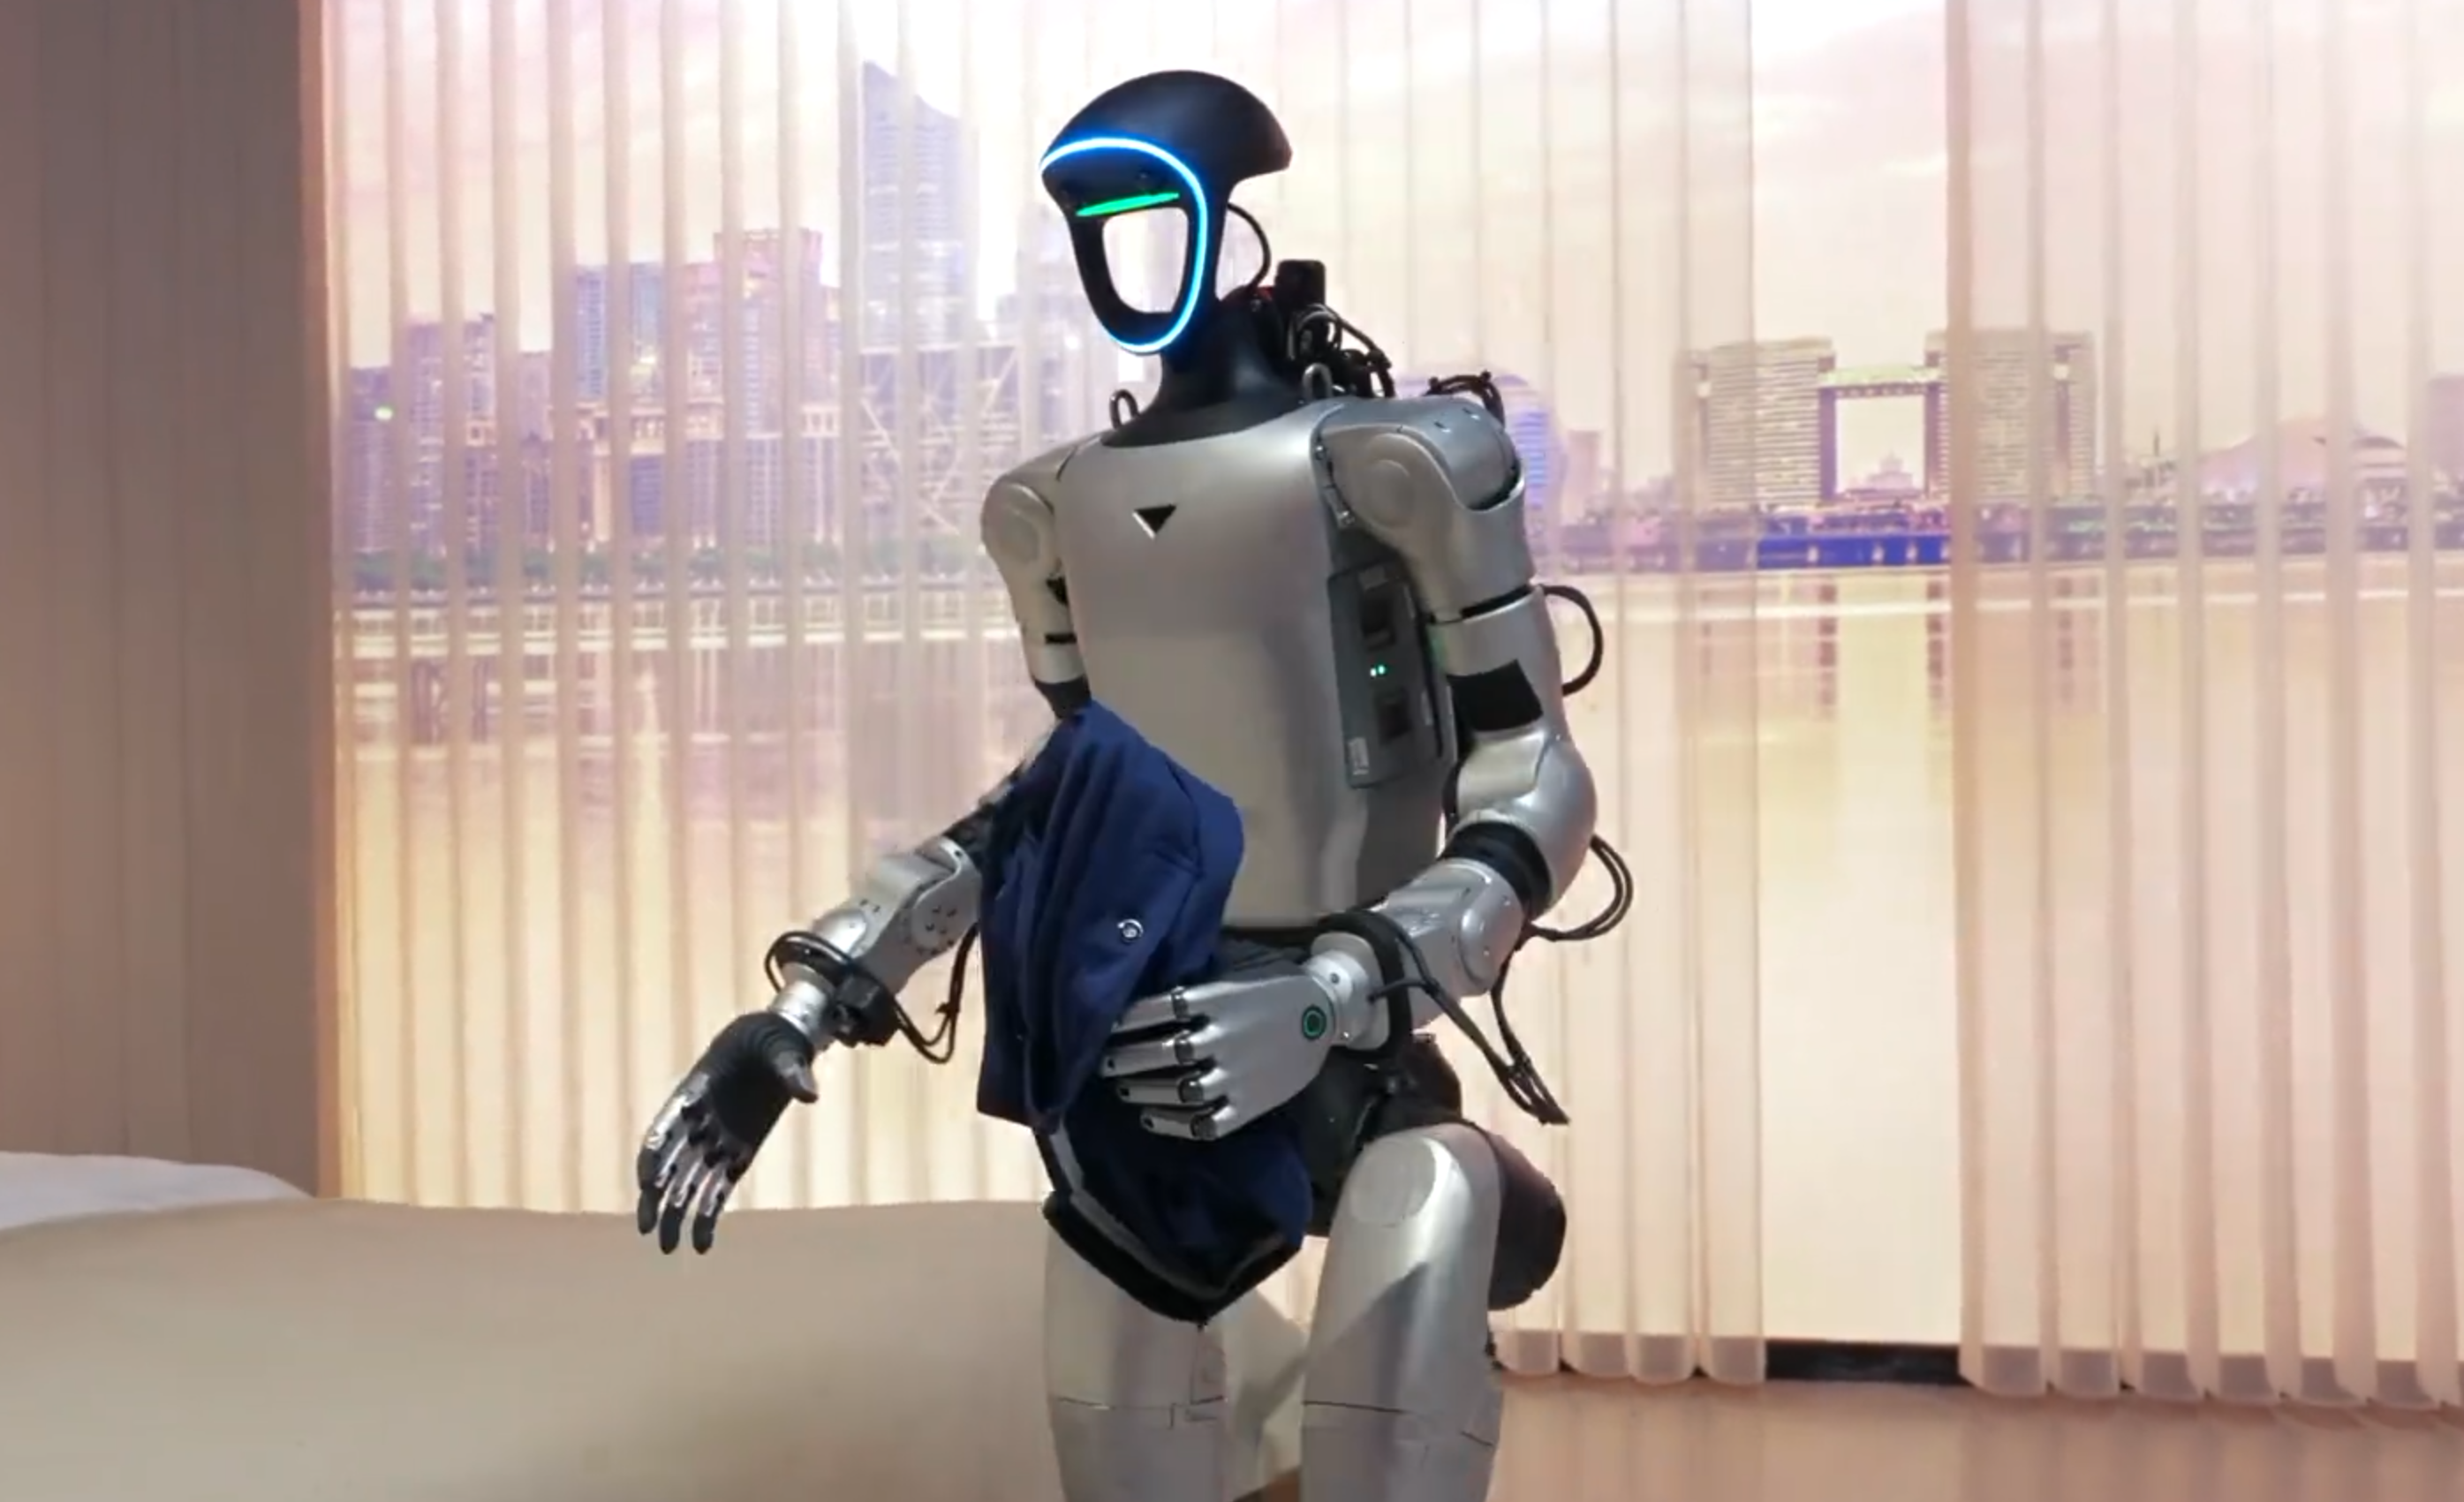
7 月 20 日,宇树科技正式发布 面向家居康养多任务 的具身大模型宇树 UnifoLM OminiA 0.3,并且该模型原生搭载于宇树 G1 机器人,标志着宇树机器人在民用服务赛道进入实质性落地阶段。 从官方描述来看,宇树 UnifoLM…

和王啸峰聊聊 Gigaworld-1:当世界模型成为具身智能的物理裁判
语言模型的评测几乎是即时的。训练一停,把测试集丢给 GPU,几秒钟就能拿到一串分数,好还是不好,一眼就能看出来。 换成机器人的「大脑」就完全是另一回事了。一个 VLA 模型刚迭代出新版本,研究员没法在屏幕前把它评完——他们得把新策略刷进真机…
不止于预测,小米将世界模型打造成数据引擎
7 月 14 日,小米放出其自研机器人在工厂中连续作业的任务视频,视频中可以看到机器人在面对不同尺寸工件依然可以长时间稳定作业。 然而,机器人在工厂里的稳定作业,只是最终呈现出来的结果。真正支撑这一结果的,是机器人背后的模型能力。模型能力决…