
 EN
接收
共 49 篇相关内容
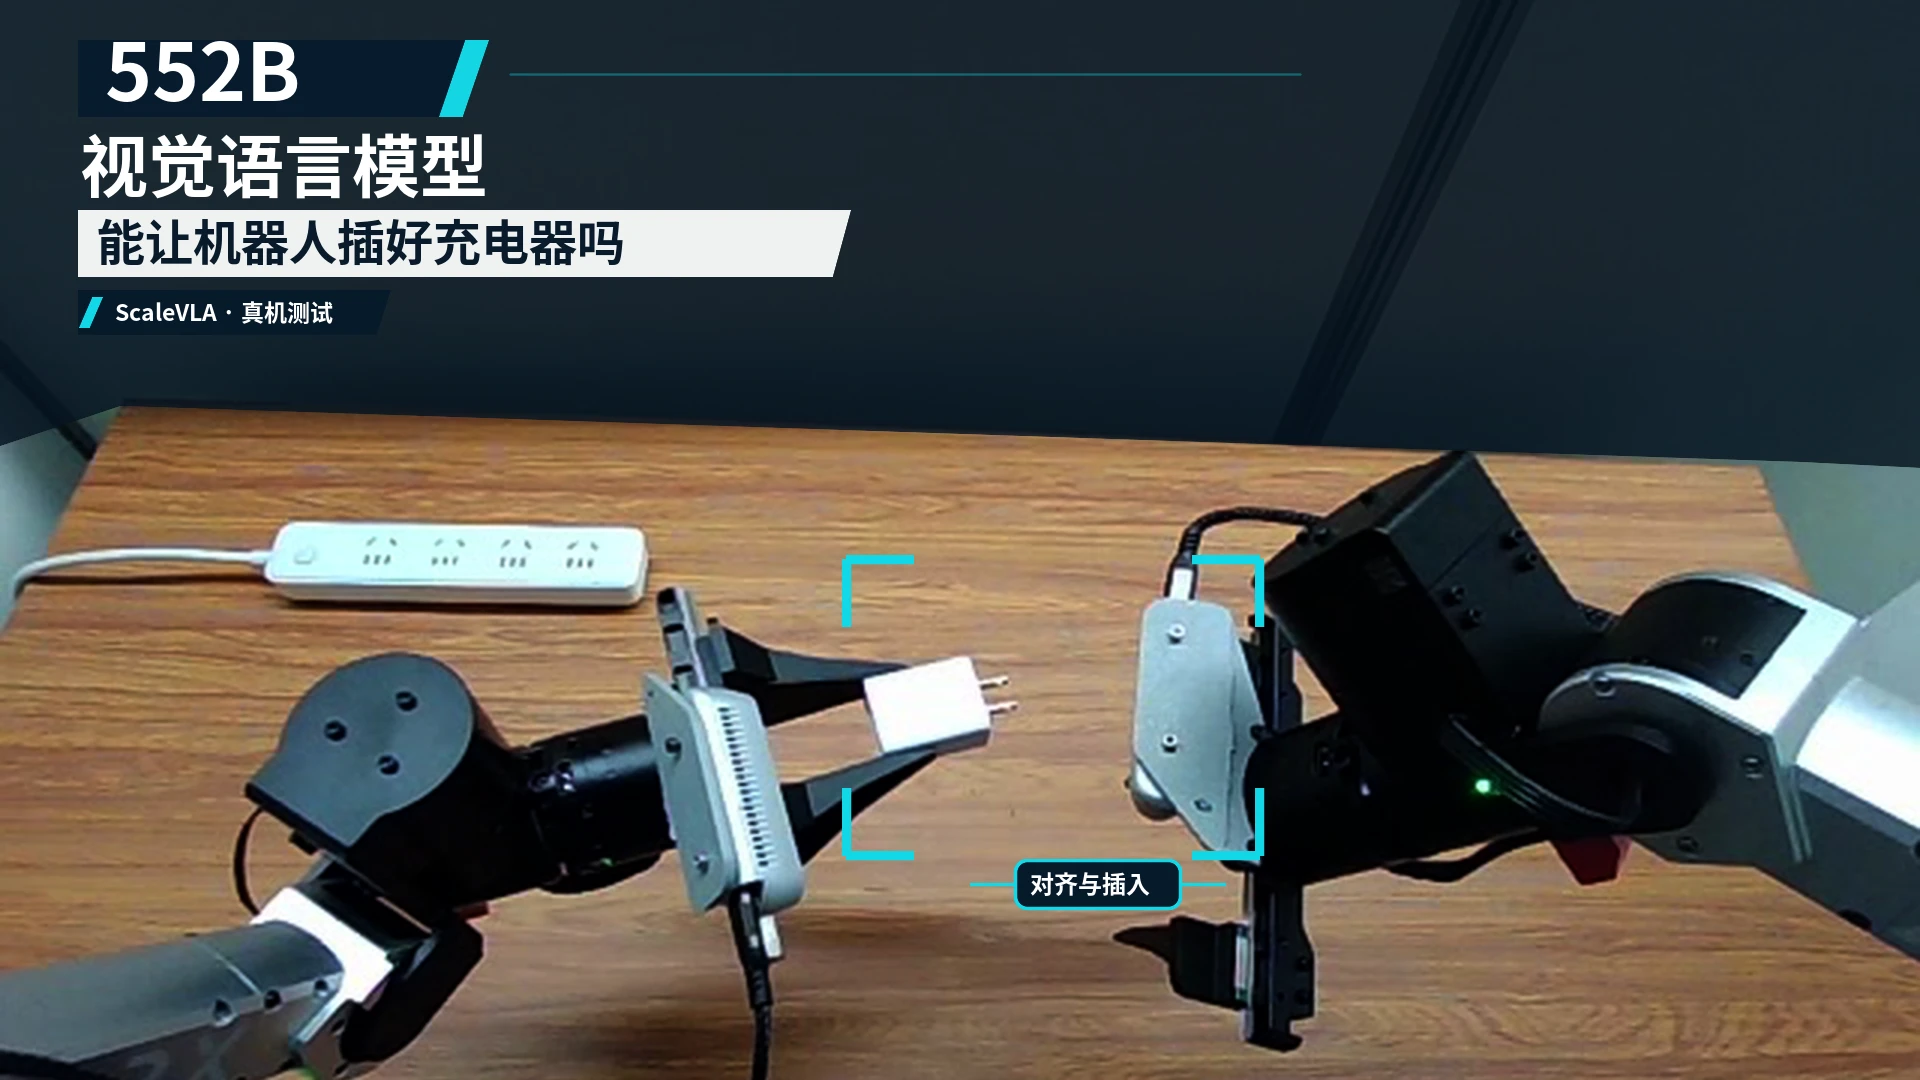
清华大学、银河通用将 552B 视觉语言表征用于机器人精细操作
视觉语言模型在大规模图文预训练中积累了物体识别、空间理解和指令处理能力。前沿模型开始展现机器人操作能力,但不少视觉—语言—动作模型(VLA)的视觉语言主干仍然较小。 大模型从图文数据中学到的表征,能否转化成更省示范、更适合精细操作的机器人策…
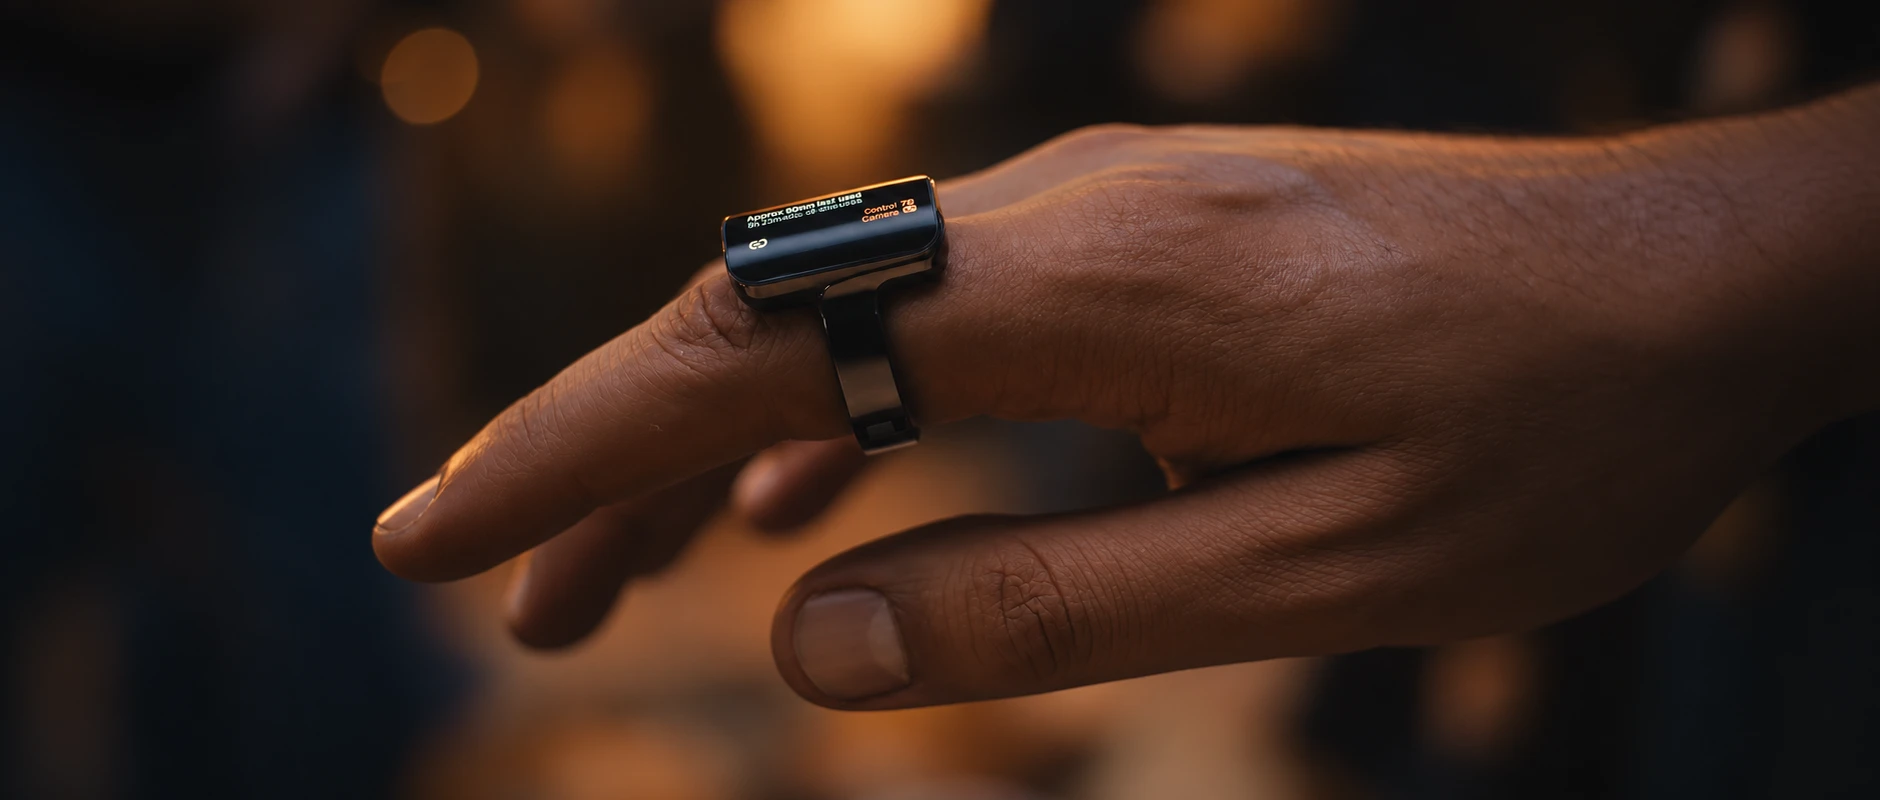
399 美元买一个确认键,Agent 时代真需要这么多审批吗?
美国时间 11 月 5 日,硬件创业公司 Aina 开启了同名智能戒指 Aina Ring 的预售。早鸟价 399 美元,后续正常价格 499 美元,下单时需要在官网全款结清,预计 2027 年初发货。 和市面上绝大多数测睡眠、测心率的智能…
Chelsea Finn:不必显式世界模型,端到端策略也能做长任务 |CoRL 2026
11 月 12 日上午,机器人学习会议(CoRL)在奥斯汀 JW Marriott 的 Brazos 房间举行半日工作坊「机器人需要世界模型吗?」(Do Robots Need World Models?)按照工作坊的官方说明,世界模型(w…
星尘智能发布 CoMind 框架,探索机器人主动协同
11 月 13 日,星尘智能发布 CoMind(Be My Eye)多机协同框架。该框架面向机器人协作中的视野遮挡与信息传递问题,尝试让机器人主动筛选并共享影响队友决策的任务信息,而不是依赖中心节点分配每一步动作,或直接传输大量原始数据。 …
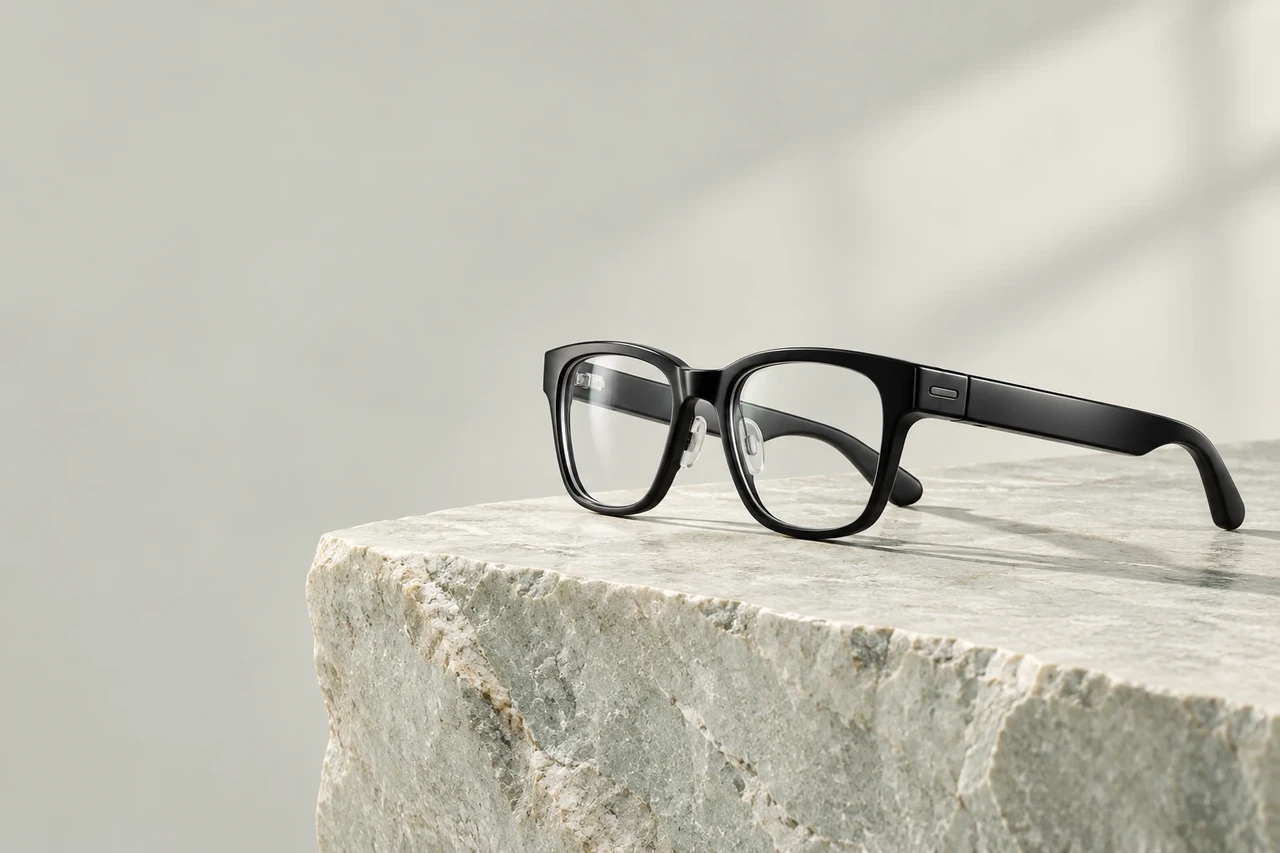
不出声,也能语音输入?这副眼镜能把没说出口的话变成文字
美国时间 10 月 30 日,创业公司 Subvocal 宣布获得由 Afore Capital 和 Y Combinator 投资的 130 万美元融资,并同步在官网开启了首款智能眼镜的预订,早鸟价定在 499 美元,预计 2027 年一…
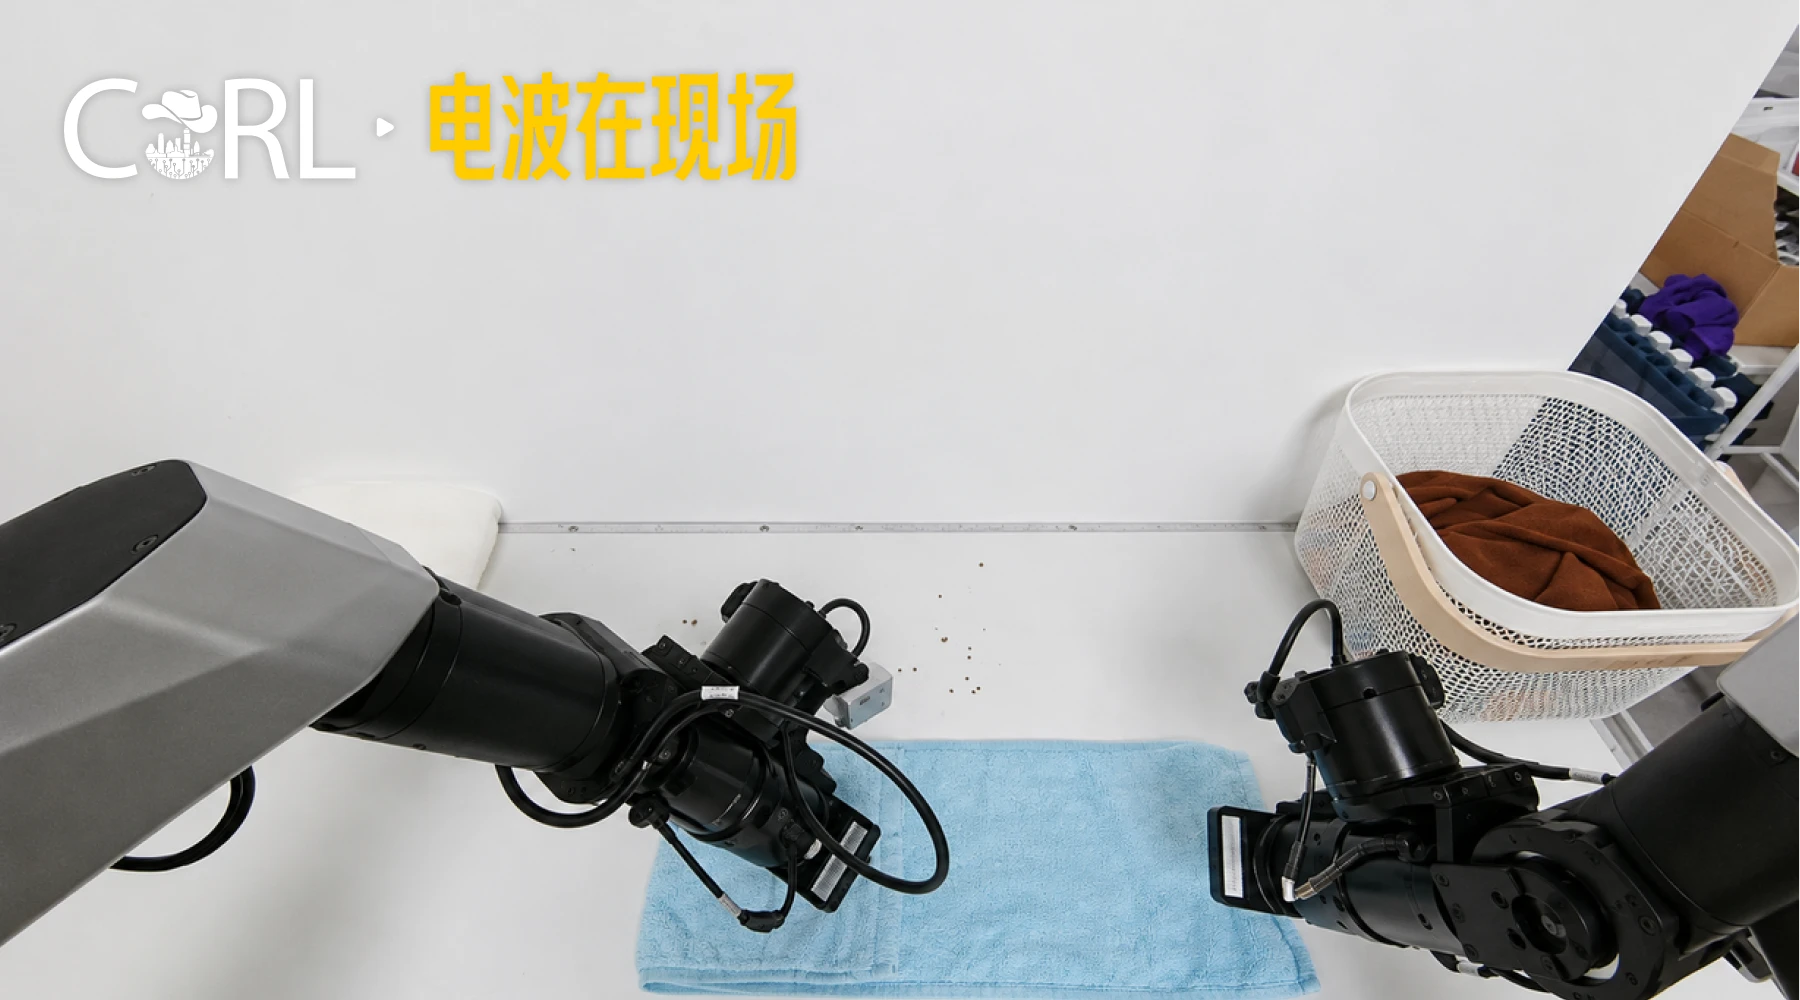
机器人 97% 的时间都在等大模型,星海图赵行谈破解实时性难题|CoRL 2026
11 月 9 日,CoRL 2026 机器人学习大会在美国得克萨斯州奥斯汀举行。当地时间 9:30 – 10:00,大会举行首场早期职业主旨演讲。 清华大学交叉信息研究院助理教授、星海图联合创始人兼首席科学家赵行,以「Organizing …
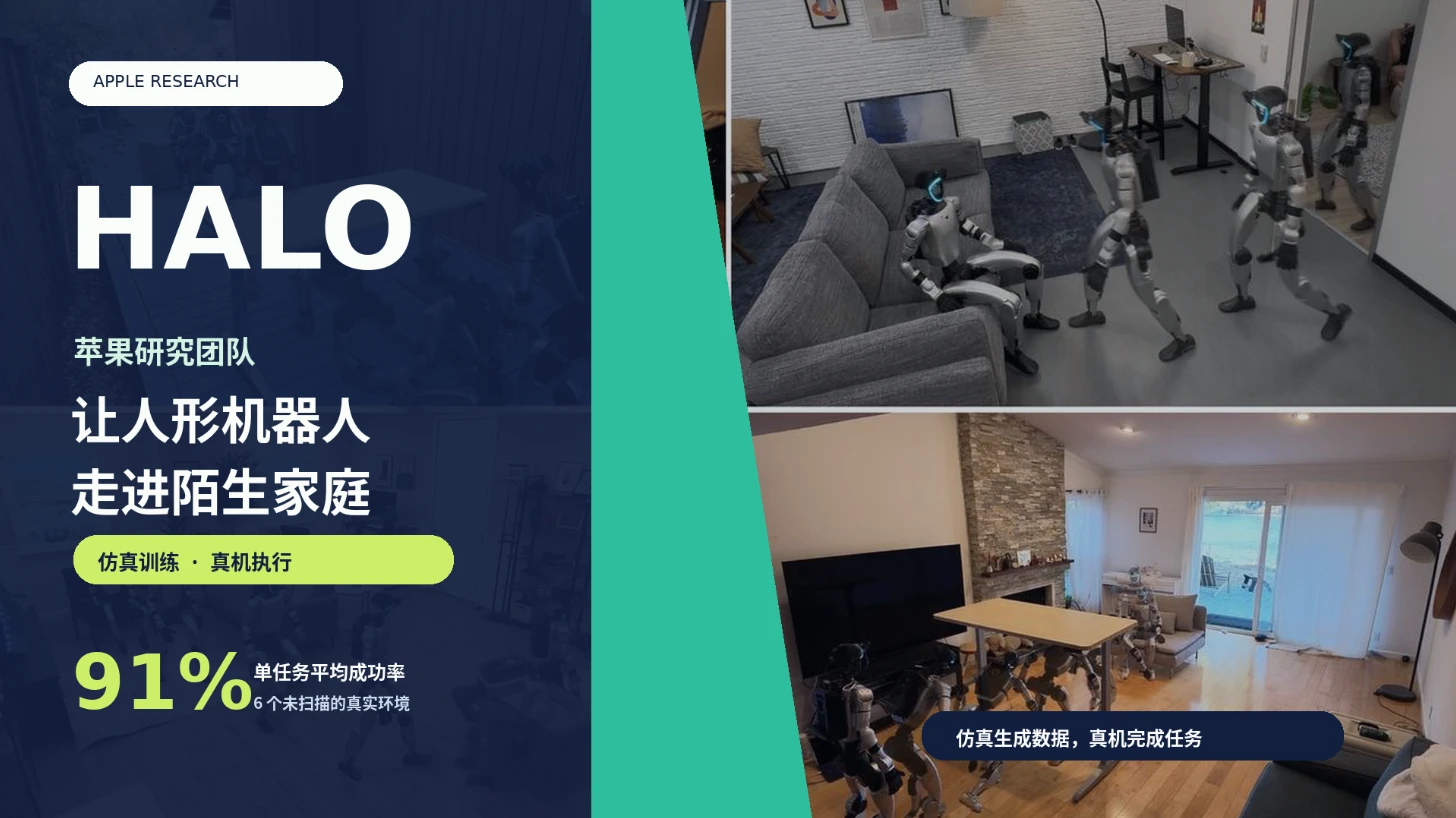
苹果把人形感知写进仿真,HALO 或零样本入户
机器人会复现预先编排的动作,不等于能在陌生家庭里自主完成任务。要完成家庭任务,机器人既要听懂指令、找到目标物体,也要根据环境规划动作,靠近目标并完成交互。 那么,怎样只用仿真数据训练,让机器人在没见过、没扫描过的真实家庭里做到这些? 11 …
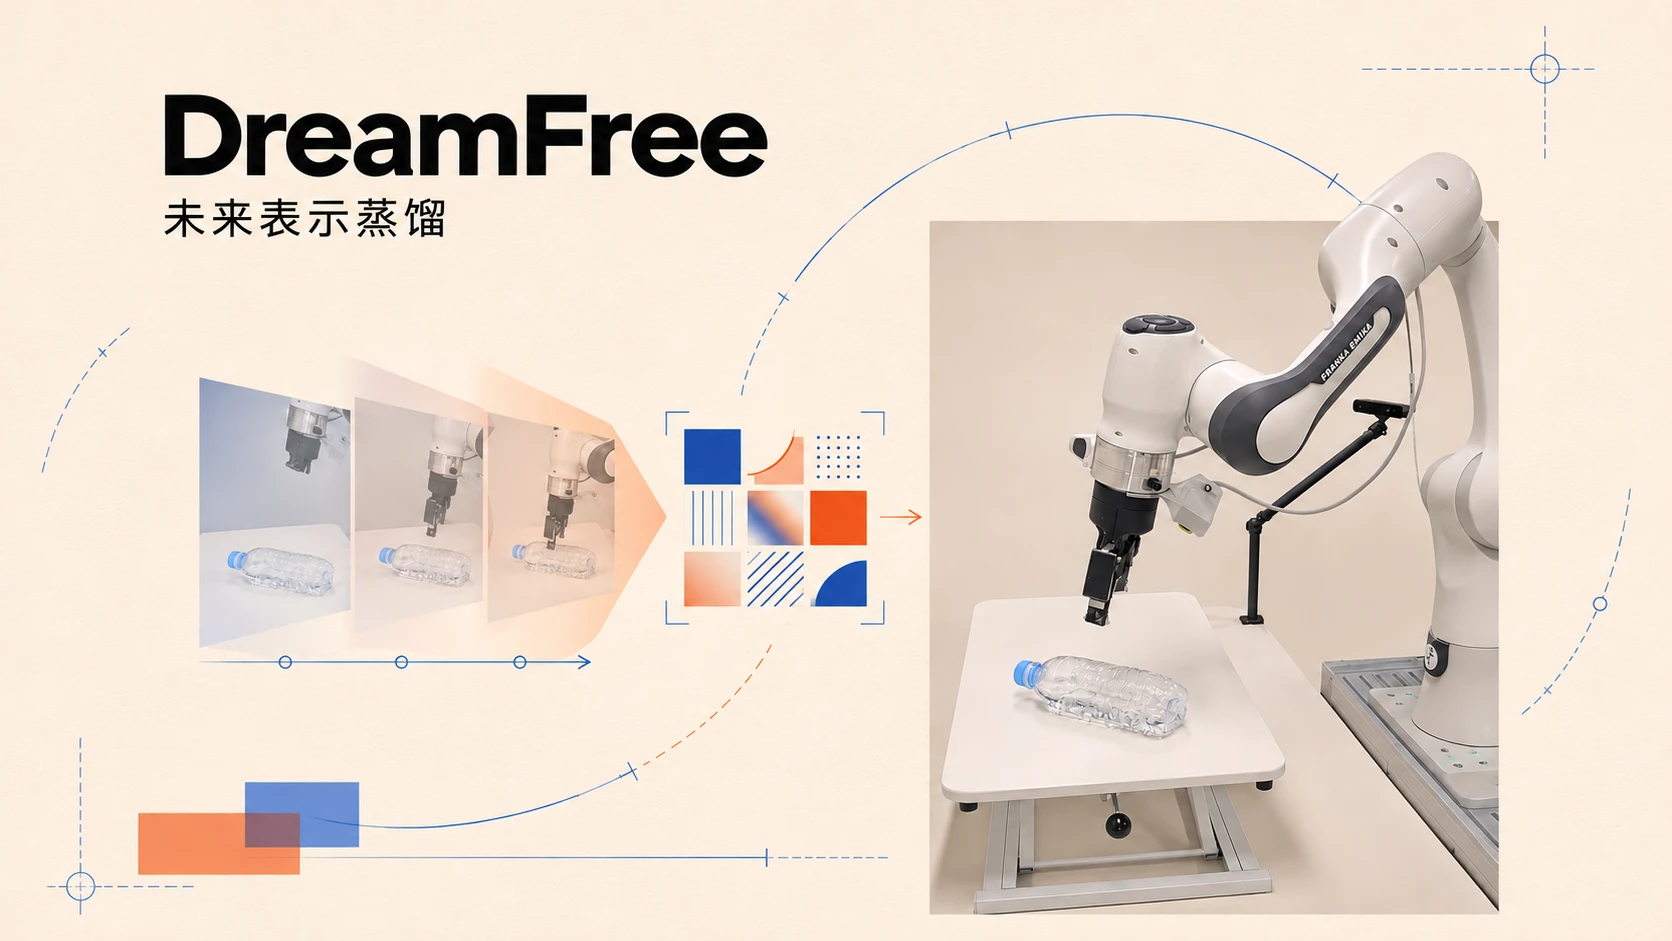
DreamFree 依托表征蒸馏,脱离未来视频生成实现机器人控制
机器人想要学会操作,首先要预判场景接下来会如何变化。不少世界动作模型会借助预训练视频扩散模型完成这件事:先脑补出未来画面,再依据画面输出动作。但生成想象画面是部署阶段成本最高的环节,生成一组动作序列需要执行数十步去噪。一旦想象的画面出现偏差…
下载破 220 万,蚂蚁灵波 LingBot 亮相乌镇峰会
11 月 2 日至 5 日,2026 世界互联网大会乌镇峰会在浙江乌镇举办,本届大会主题为「开源开放 共建共享 —— 携手构建网络空间命运共同体」。 据封面新闻报道,蚂蚁集团旗下具身智能公司蚂蚁灵波,携全栈开源的机器人通用大脑亮相本次峰会,…
清华团队提出 Utility-WAM,按需启用未来视频做机器人动作规划
把「先想几帧未来画面,再出动作」写进策略,是具身智能近两年很受关注的技术路线。机器人可以在模型内部推演后续场景画面,让动作规划获得动态前瞻能力,理论上更适配长程、多阶段任务。 但是,预测未来画面会改动模型输出的动作,改动有好有坏,正负效果互…

对话 Copper-Policy 团队:从像素预测走向紧凑世界表征
为了让机器人具备更强的认知与物理交互能力,研究者开始探索世界动作模型(WAM)。WAM 通过视觉动力学预测场景的演化,将「世界应当变成什么样」与「机器人如何实现这一变化」联系起来。即使测试时不生成未来,联合训练的收益仍然存在。 那么,WAM…
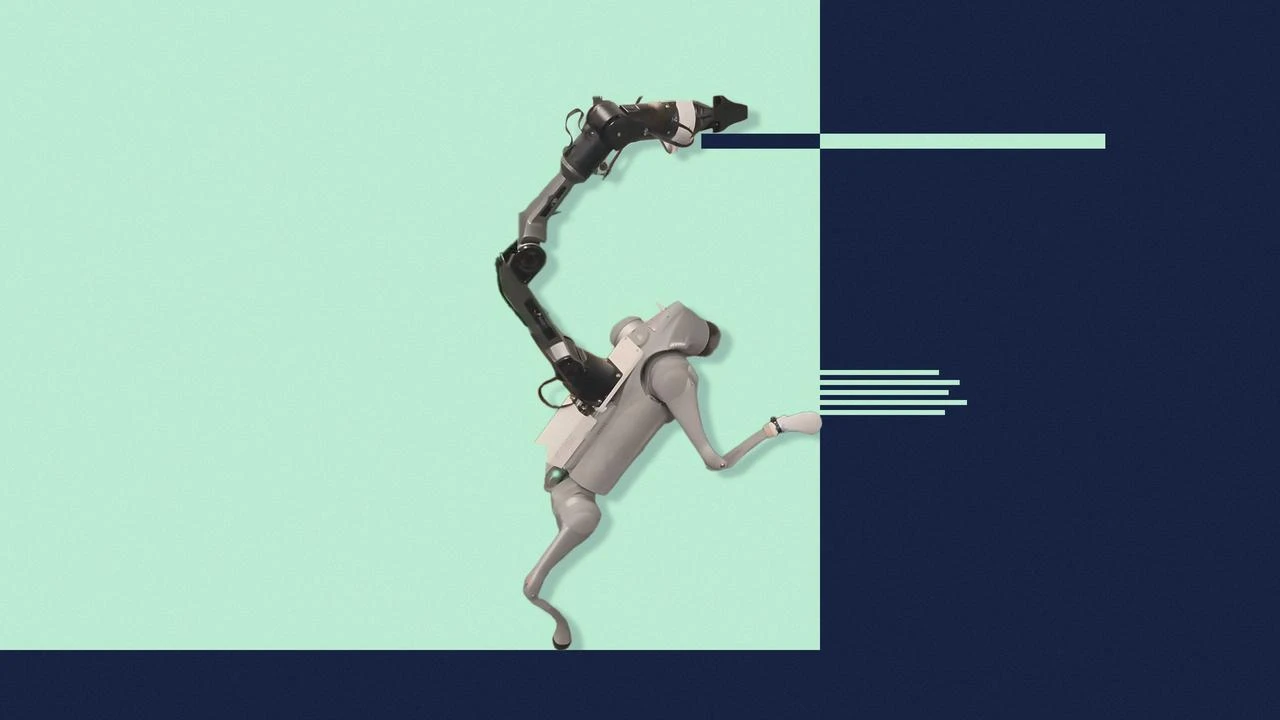
从任务失败中获取新控制器,卡内基梅隆团队用 ELEVATE 帮机器狗补能力
搭载机械臂的四足机器人,比轮式机器人更能适应复杂环境。但却有一个硬限制:所有动作都要提前训练好,存进动作库里。 如果库里没有对应的动作,哪怕换再多任务代码,机器人也做不出这个姿态。 那么机器人可不可以自己发现,任务失败是因为缺少哪个动作,然…