

提出
共 91 篇相关内容
特斯拉三季报确认人形机器人投产,Optimus 进入早期爬坡
特斯拉三季报确认人形机器人投产,Optimus 进入早期爬坡 特斯拉在这次三季报里给出了一个明确的机器人进展:Optimus 已经在弗里蒙特开始生产,加州项目进入早期爬坡。 美国当地时间 10 月 21 日,特斯拉发布 2026 年第三季度…
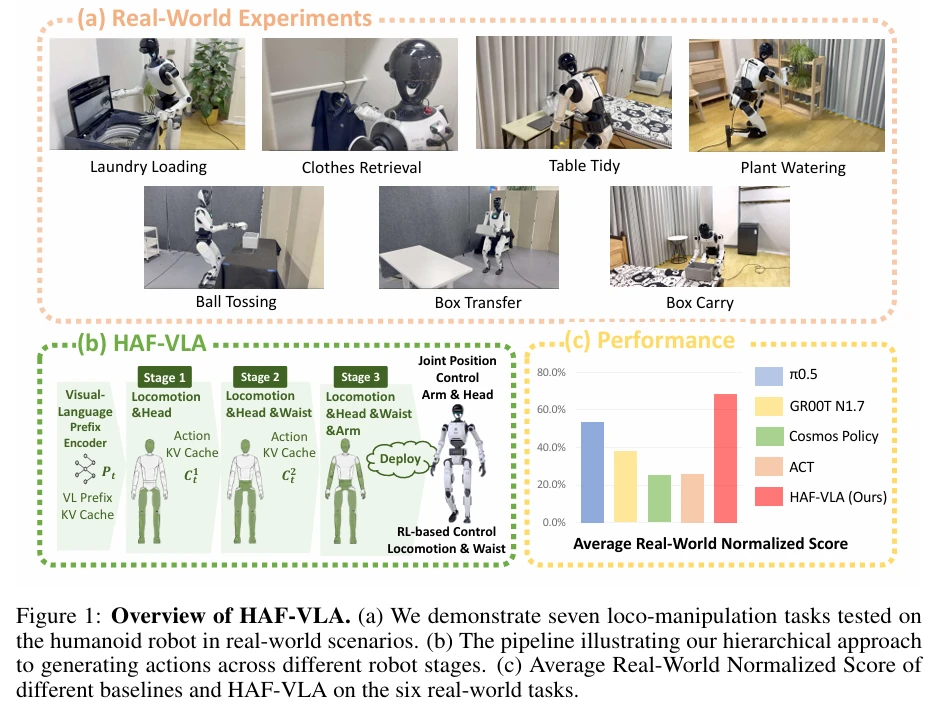
仉尚航等提出 HAF-VLA,让人形机器人分层生成协调的全身动作
仉尚航等提出 HAF VLA,让人形机器人分层生成协调的全身动作 人形机器人要学会自主走向目标、俯身、再伸手抓取,卡点在于全身动作的协同生成。腿、腰、头部与双臂串联在同一条运动学链上:底盘偏移几厘米、腰部角度差几度,手臂就得伸得更远代偿。持…
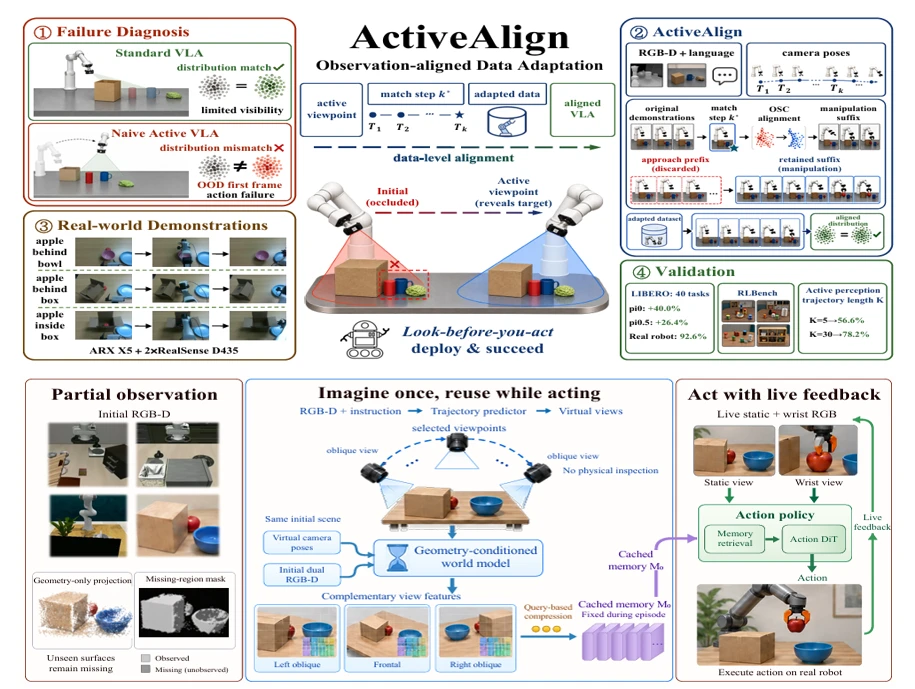
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作 机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关…
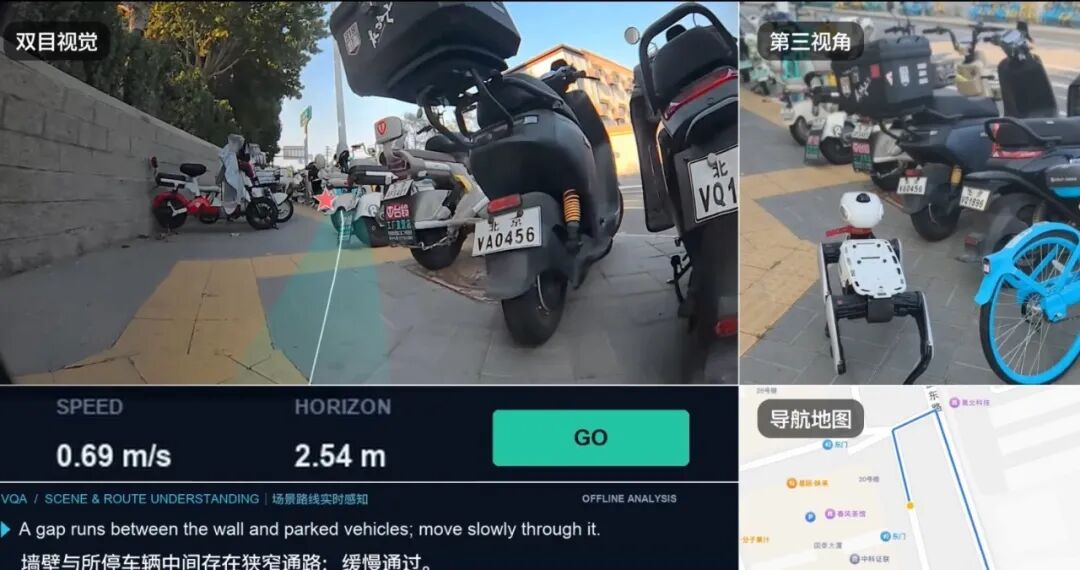
机器人都能跑马拉松了,为什么走到前台还这么难?
机器人越来越会动了。四足机器人爬楼梯、翻越障碍早已不新鲜。今年北京亦庄的人形机器人半程马拉松上,甚至有近四成参赛队伍采用自主导航方式。 但如果终点不是赛道上的冲线,而是某栋写字楼的前台呢? 在 Vbot(维他动力)展示的一段导航演示中,机器…
工博会的具身展台「静悄悄」
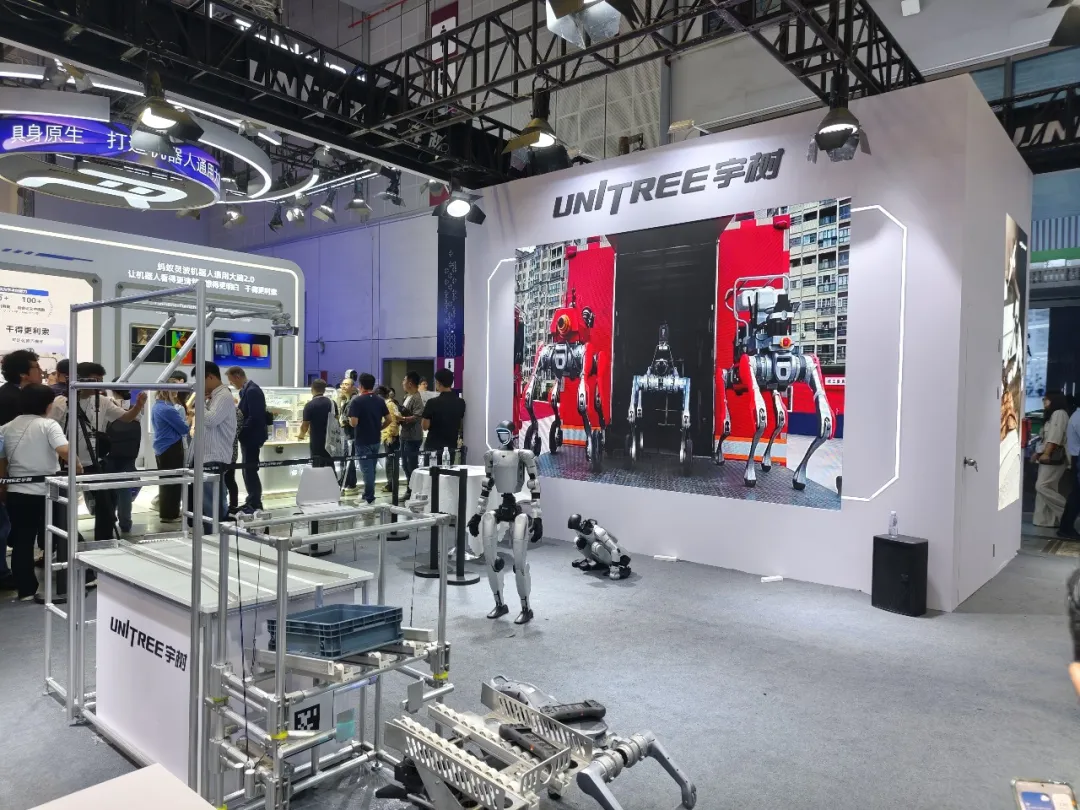
「宇树这次的展台真小。」 在今年工博会上,我们听到一位观众经过宇树科技展台时发出了这样的感慨。 当时离闭馆这一「下班时间」还有两个多小时,展台上的机器人们已经集体进入了「摸鱼」时间。没有接连不断的运动表演,自然也少了围观的人群。 而此前的 …
Jim Fan、韩松团队提出 Robota-Embed:机器人检索经验,动作比画面更关键
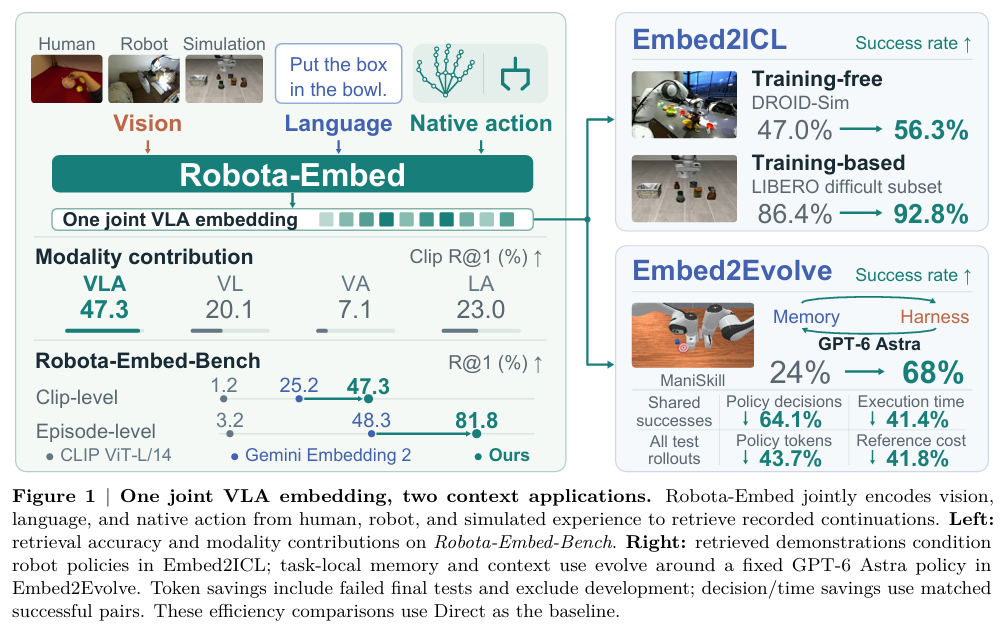
具身智能机器人想要复用过往操作经验,普遍会检索历史示范视频,模仿曾经成功的操作。 但传统检索大多只比对画面外观:只要桌子、物体看起来一致,就判定是匹配片段,忽略机械手当下的运动方向。同样的纸箱、同一段胶带,封箱和撕胶带两张画面几乎看不出差别…
对话启元首席科学家董豪:机器人进家之前,先把「学费」打下来
今年 9 月,在智能机器人与系统国际会议(IROS 2026)期间,启元机器人与北京大学董豪团队举办了一场面向真实家庭场景的双臂操作挑战赛。参赛者利用示范数据训练模型,入围模型再部署到真实机器人上,执行开洗衣机门、装衣服、叠衣服等任务。最终…
「摔倒」方显真差距,I-BFM 把物理交互训进行为基座模型
这两年有不少惊艳的机器人搬箱子的 demo,但不知道大家是否有注意到一个细节,绝大多数 demo 里,一切都是按剧本走的。箱子摆在它该在的位置,机器人站得笔直,一遍过,没有任何干扰,甚至大部分镜头里都没有人的出现。 现实世界不是这样。手会没…
王晓刚、李鸿升团队新作:260 万个场景训练灵巧手
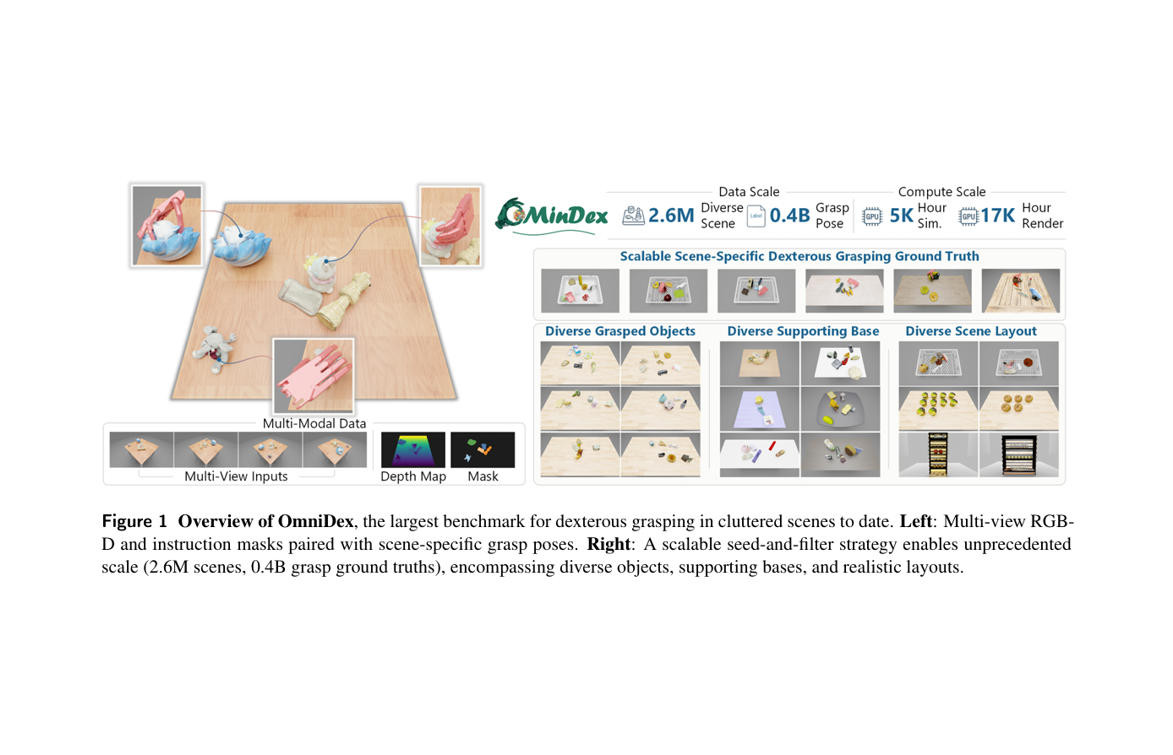
OmniDex 借助可复用种子抓取库搭配碰撞筛选,将杂乱场景下的灵巧手抓取数据集规模从数千个扩充至 260 万个场景、约 4 亿条抓取标注;配套采用软胜者全取学习与物理约束的生成模型,省去推理阶段反复优化抓取位姿的步骤。 10 月 8 日,…
传 DeepSeek 将投入具身智能赛道,中美基础大模型公司齐现重大信号
10 月 12 日夜,有消息传出 DeepSeek 创始人梁文锋近期密切关注具身智能领域,DeepSeek 正在评估是否进入具身智能赛道,方案可能包括亲自组建团队下场研发,或通过投资相关企业切入。另据彭博社报道,DeepSeek 计划领投腾…
杨立昆 JEPA 最新论文,端到端规划的下一程在哪?
有关具身智能,JEPA 是世界模型内一个无法回避且值得反复讨论的技术路线。它拥有很多颇具希望的特质:更好的抗干扰能力、更高效的计算与训练效率、极低的数据标注依赖......更重要的是,JEPA 基于表征学习来捕捉物理世界的规律,从而进行实 …
智在无界卢宗青团队提出 Being-M0.7,依托人类视频动作先验,训练人形机器人全身移动操作
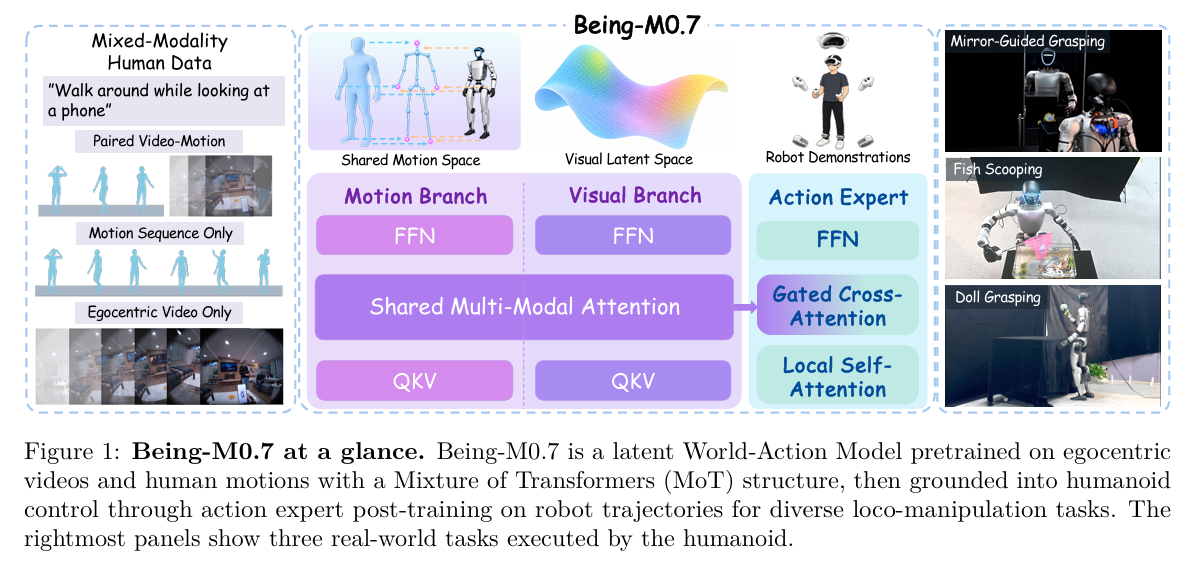
Being M0.7 依托一万余小时人类第一视角视频与人体动作数据,学习画面与全身动作的联合先验,再通过机器人轨迹完成中训与动作后训练,输出人形机器人全身移动 + 操作的控制指令。模型在 SIMPLE 仿真基准中综合成功率 71.1%,位列…